Advancing coding: להעביר COBOL עם agent בלי לשבור אגורה
מיגרציית COBOL עם agent בשישה צעדים: golden master, חוזה ב-AGENTS.md, diff ברמת byte ו-escalation של reasoning effort רק למה שנפל.
המודל הוא כבר לא החלק הקשה במיגרציה של COBOL. החלק הקשה הוא ה-golden set שלכם.
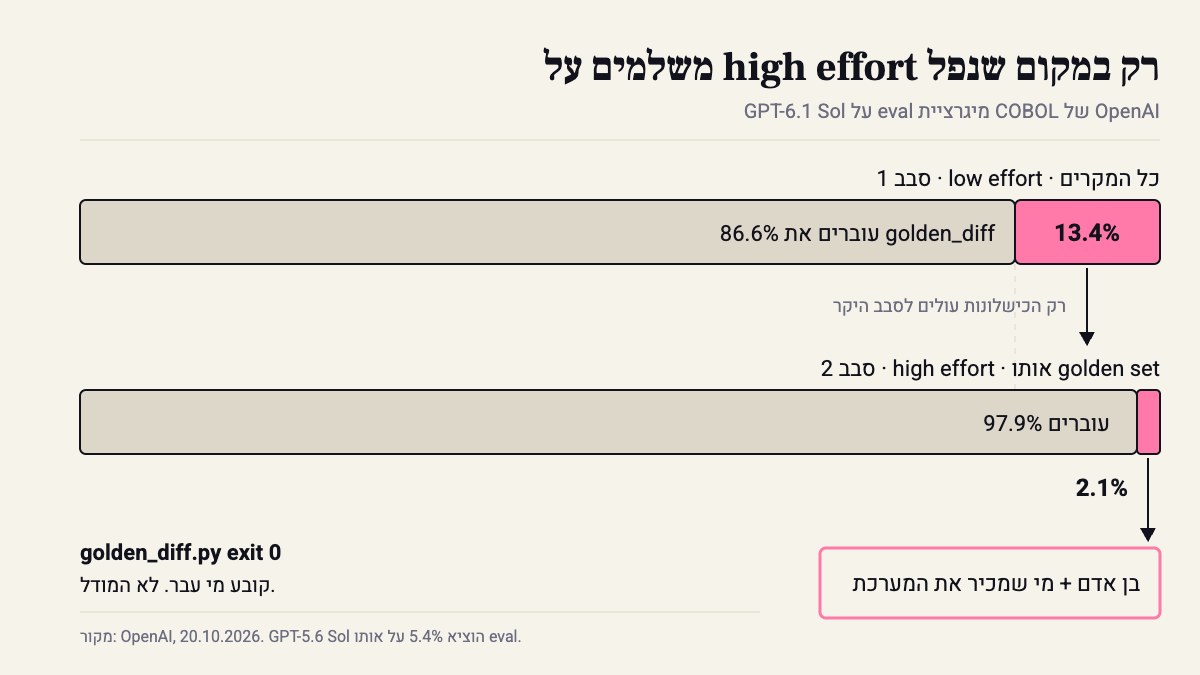
ב-20 באוקטובר OpenAI פרסמה ש-GPT-6.1 Sol מעביר תוכניות COBOL לשפה אחרת ב-86.6% דיוק ב-low reasoning effort, וב-97.9% ב-high. הדור הקודם, GPT-5.6 Sol, הוציא 5.4% על אותו eval. זו קפיצה אמיתית, והמודל גם זול יותר ב-39%. אבל תסתכלו מה בדיוק הם מדדו. לא אם הקוד החדש נקי. הם מדדו אם הוא מתנהג בדיוק כמו הישן. אם אין אצלכם מכונה שעונה על השאלה הזו, ה-97.9% שלהם לא עוזר לכם בכלום.
ו-COBOL לא הולך לשום מקום. לפי IBM, ש-OpenAI מצטטת, הוא עדיין מאחורי יותר מ-40% ממערכות ה-online banking, 80% מעסקאות האשראי הפרונטליות ו-95% מעסקאות הכספומט. מי שעבד בבנק, בביטוח או במשרד ממשלתי ראה את זה מקרוב.
אז ככה הייתי מריץ מיגרציה כזו עם agent, בין אם זה קלוד קוד, Codex או מה שיש לכם בבית. הדוגמה לאורך כל הפוסט היא תוכנית batch אחת שמחשבת ריבית, INTCALC.cbl, שעוברת ל-Python.
01 · בוחרים תוכנית אחת, לא מערכת
קודם כל scope. לא “נעביר את ה-core”. לוקחים תוכנית batch אחת שקוראת קובץ וכותבת קובץ, בלי מסכי CICS ובלי SQL מוטמע. אלה יגיעו אחר כך, אחרי שיש לכם שיטה.
ככה מוצאים מועמדים: grep -L -E "EXEC (CICS|SQL)" src/*.cbl | xargs wc -l | sort -n | head -20. תקבלו רשימה של תוכניות בלי תלויות חיצוניות, מהקטנה לגדולה. לדעתי כדאי להתחיל ממשהו באמצע הרשימה. התוכנית הכי קטנה בדרך כלל לא עושה שום דבר מעניין, ואז לא תלמדו ממנה כלום.
רגע, למה להתחיל מהתנהגות ולא מהקוד? OpenAI ניסחו את זה הכי טוב:
Documentation may be incomplete, original developers may have left the company, and important business rules may only exist in code.
OpenAI, “Advancing coding in low-resource programming languages”, 20.10.2026
בקיצור, הקוד הוא ה-spec, ואין spec אחר.
02 · מקליטים את ההתנהגות לפני שנוגעים בשורה
קוראים לזה golden master, וזו טכניקה ישנה מעולם ה-legacy, הרבה לפני LLMs. מריצים את התוכנית הישנה על הרבה קלטים, שומרים את הפלט, ומעכשיו הפלט הזה הוא האמת.
הקלטים: שבוע של קבצי batch אמיתיים אחרי התממה, ועוד סט ידני של מקרי קצה. אפס, ערך שלילי, הערך המקסימלי שה-PIC מחזיק, וגלישה. גלישה? כן. שדה PIC 9(5) שמקבל 123456 שומר 23456, בשקט, אם אין ON SIZE ERROR. את ההתנהגות הזו צריך לשמר. אם רוצים לתקן אותה, מחליטים על זה במפורש, בכרטיס נפרד.
set -euo pipefailcobc -x -o legacy/intcalc src/INTCALC.cblfor f in golden/cases/*.dat; do ./legacy/intcalc < "$f" > "${f%.dat}.out"donels golden/cases/*.out | wc -lמה שכן, GnuCOBOL על לינוקס הוא לא mainframe. EBCDIC מול ASCII משנה את סדר המיון, ומספרים ארוזים (COMP-3) יכולים להתנהג אחרת. אם יש לכם גישה, תקליטו את קבצי ה-.out על המכונה האמיתית ותמשכו אותם לריפו. נראה לי ש-300 זוגות של קלט ופלט זה מינימום סביר לתוכנית אחת.
03 · כותבים ל-agent חוזה, לא היסטוריה
ה-agent לא צריך לדעת למה מישהו הוסיף את התנאי ההוא ב-1994. הוא צריך כללים שאפשר לבדוק. שמים קובץ אחד בשורש הריפו, AGENTS.md, או CLAUDE.md אם אתם על קלוד קוד:
- Never edit anything under golden/.- Money is Decimal, never float.- PIC S9(7)V99 -> Decimal, quantize to 0.01.- COBOL ROUNDED -> ROUND_HALF_UP. No ROUNDED -> ROUND_DOWN (truncate).- Output is fixed-width. Keep leading zeros and trailing spaces.- Done means `python3 golden_diff.py` exits 0. Not before.שורת העיגול שווה זהב. ב-Python ה-context של decimal מעגל כברירת מחדל ב-ROUND_HALF_EVEN, כלומר עיגול בנקאי. COBOL עם ROUNDED מעגל חצי כלפי מעלה, ובלי ROUNDED הוא פשוט חותך. אז 2.345 יוצא 2.34 ב-Python ו-2.35 ב-COBOL. זו אגורה אחת, וכשמכפילים אותה במיליון רשומות בלילה, יש לכם בעיה.
השורה הראשונה בקובץ חשובה לא פחות. agent שנתקע מחפש את הדרך הכי קצרה ל-exit 0, ולפעמים הדרך הזו היא לעדכן את ה-.out. לכן תריצו chmod -R a-w golden/ לפני שהוא מתחיל.
04 · ה-agent רץ מול diff, לא מול תחושה
זה בעצם מה שה-eval של OpenAI עושה: מריצים, משווים וסופרים. אצלכם זה נראה ככה:
import json, pathlib, subprocess, sys
CASES = pathlib.Path("golden/cases")NEW = ["python3", "-m", "intcalc"]
cases = sorted(CASES.glob("*.dat"))fails = []for case in cases:    expected = case.with_suffix(".out").read_bytes()    r = subprocess.run(NEW, input=case.read_bytes(), capture_output=True, timeout=30)    if r.returncode != 0 or r.stdout != expected:        fails.append(case.name)
passed = len(cases) - len(fails)print(json.dumps({"cases": len(cases), "passed": passed,                  "rate": round(passed / max(len(cases), 1), 3),                  "fails": fails[:20]}))sys.exit(1 if fails else 0)
הפלט הוא שורה אחת של JSON, למשל {"cases": 300, "passed": 261, "rate": 0.87, ...}. ה-agent קורא אותה, פותח את הכישלון הראשון, מתקן ומריץ שוב. ההשוואה היא ברמת ה-byte, ובכוונה. במערכת פיננסית “כמעט זהה” זה באג.
Benj Edwards מ-Ars Technica בנה 50 פרויקטים עם קלוד קוד ואופוס 4.5 מאז נובמבר 2025, והשווה את החוויה למדפסת תלת-ממד: משהו יוצא, אבל הוא לא מוכן לייצור. בגדול, ה-diff הוא מה שמפריד בין “יצא משהו” לבין “מוכן”.
05 · low effort לכולם, high effort רק למה שנפל
עכשיו לכסף. לפי OpenAI, ב-low effort המודל סוגר 86.6%, וב-high הוא מגיע ל-97.9%. אין שום סיבה לשלם על high effort לכל התוכנית. מריצים סבב ראשון בזול, ומעבירים לסבב היקר רק את המקרים שנפלו:
python3 golden_diff.py | jq -r '.fails[]' > failing.txtcodex exec -c model_reasoning_effort=high \ "Make these golden cases pass: $(paste -sd' ' failing.txt). Do not touch golden/."אותו היגיון עובד גם כשבוחרים מודל. ב-MultiLangBench, שבו המודל בונה מאפס מנוע תואם SQLite ב-20 שפות, GPT-6 Luna הגיע ל-40.3% בעלות API נמוכה בכ-78%, מול 87.4% של GPT-6 Astra. זול זה יפה, אבל אם חצי מהמקרים נופלים, תשלמו את ההפרש בסבבים נוספים.
הסתייגות: אלה המספרים של OpenAI, על ה-eval שהם בנו ועל התוכניות שהם בחרו. אני לא מכיר את ה-COBOL שלכם, והם גם לא. תתייחסו ל-86.6% כנקודת השוואה לסבב הראשון שלכם, לא כהבטחה.
06 · מודדים pass rate, וגם כמה זה עלה
לכל תוכנית תרשמו שורה אחת: כמה מקרים יש, pass rate בסבב הראשון, pass rate סופי, כמה סבבים זה לקח וכמה דולר זה עלה. את העלות רואים ב-/cost בקלוד קוד וב-/status ב-Codex. אחרי עשר תוכניות יהיה לכם מספר אמיתי: כמה עולה להעביר 1,000 שורות COBOL אצלכם. את המספר הזה מביאים להנהלה, לא את ה-benchmark.
את מה שנשאר אחרי high effort אי אפשר למדוד אוטומטית. ה-2.1% האלה הם בדיוק החוקים העסקיים שאף אחד כבר לא זוכר. בן אדם צריך לקרוא אותם, ועדיף שמישהו שמכיר את המערכת יישב לידו.
מה לקחת
- golden set לפני שורת הקוד הראשונה. בלי golden set זו לא מיגרציה, זה rewrite.
- כללי decimal ועיגול כתובים ב-AGENTS.md, עם
ROUND_HALF_UPבמפורש. - low effort לכולם, high effort רק לכישלונות, ובן אדם רק ל-2% האחרונים.
golden/לקריאה בלבד. agent שמותר לו לגעת בתשובות ימצא אותן.
מקורות
- Advancing coding in low‑resource programming languages · 2026-10-20
- Advancing coding in low‑resource programming languages · 2026-10-20
- From Copilot to agents: The history of AI coding
- How do AI coding agents work? - by Rich Holmes
- 10 things I learned from burning myself out with AI coding agents
- What are AI Agents?- Agents in Artificial Intelligence Explained - AWS
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 6 מקורות, ונערך ואושר על ידי קובי אלמוג.