Agentic memory: למה סוכן עם 200K tokens שכח איך כותבים תאריך
סוכן על Raspberry Pi עם 200K tokens של context שכח כלל של שורה אחת. מה נשבר, למה vector DB לא עזר, ומה לבדוק אצלכם.
- 01כללים פרוצדורליים לקובץ שנטען תמיד, לא ל-vector DB
- 02תריצו eval אחרי compaction ותבדקו שה-agent עדיין מיישם את הכללים
- 03תמדדו tokens של זיכרון לכל session. אם זה גדל, אתם אוגרים
200 אלף tokens. זה ה-context window של אופוס שחואן קרלוס רולדן עבד איתו, והוא עצמו משווה את זה לאורך של “אחוות הטבעת”. ספר שלם. ועדיין, הדוגמה שהוא בחר להראות איפה זה נשבר היא כלל של שורה אחת: תאריכים בפורמט YYYY-MM-DD.
רולדן פרסם את זה ב-6 בפברואר 2026, בפוסט קצר בשם Agentic Memory Bottlenecks. אין שם outage ואין DB שנמחק. יש agent שרץ לבד כמה שבועות ונתקע בדיוק במקום שכל מי שמריץ agents ארוכים יגיע אליו. בגלל זה שווה לפרק אותו.
Raspberry Pi 4, מנוי ב-$20 ולובסטר אחד
ההתחלה: Raspberry Pi 4 ישן, פירמוט, ו-Clawd מותקן עליו. Clawd זה עוזר אישי agentic עם פרסונה של סרטן. רולדן נתן לו מנוי Claude Pro משלו ב-$20 לחודש, גישה ל-Gmail ול-GitHub, ובוט בטלגרם. הוראות כמעט אין, רק starter pack שכתב כמה חודשים קודם. המודל אופוס, והוא רץ בערך שעה כל ארבע שעות.
הסוכן קרא לעצמו The Lobsterino. ובגדול, הוא עבד. בקשה פשוטה, והוא פותח repo, כותב טסטים, נכנס ללולאה של פיתוח והרצה, מרים cron jobs עם subagents שבודקים איכות קוד, מצלם snapshots ופותח issues. עד שזה מסתדר.
ואז המשפט שבגללו הפוסט הזה קיים:
“Given a reliable methodology and enough time it can achieve most tasks I instructed it to do. Except when the memory starts to overflow.”
— חואן קרלוס רולדן, Agentic Memory Bottlenecks
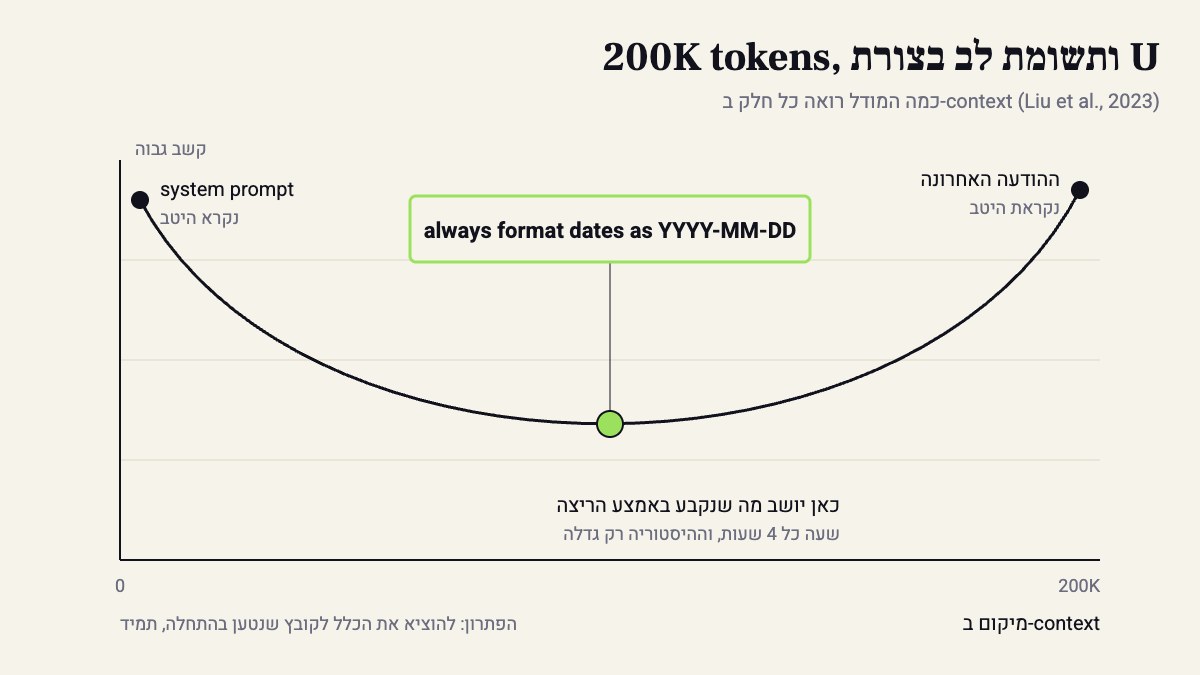
כשה-context מתמלא, נשארים רק ההתחלה והסוף
מה שנשבר זה לא הגודל. 200K זה הרבה. הבעיה היא איך המודל קורא אותם. רולדן מצביע על ה-U-shaped attention problem מהמאמר Lost in the Middle (Liu ואחרים, 2023): ב-context ארוך, מה שבהתחלה ומה שבסוף מקבל תשומת לב, ומה שבאמצע מתברבר. בפועל, הסוכן זוכר את תחילת השיחה ואת סופה.
עכשיו תחשבו על agent שרץ שעה כל ארבע שעות, וההיסטוריה שלו רק מצטברת. ה-system prompt יושב בהתחלה. ההודעה האחרונה בסוף. וכל מה שנקבע באמצע, איזה טסט נפל ולמה, על איזה פורמט הוסכם, יושב בדיוק בשקע של ה-U. רולדן קורא לזה memory derailment.
ומבחוץ זה כמעט לא נראה כמו תקלה. אין exception ואין crash. ה-agent ממשיך לרוץ ולכתוב קוד, רק שהוא מתחיל לפספס דברים שכבר נקבעו. failure שקט. הסוג הכי יקר.
התיקון הראשון: תיקיות, קבצים ו-grep
ה-agent עשה מה ש-agents עושים כשנותנים להם filesystem: התחיל לארגן זיכרון לפי משימה בתיקיות ובקבצים, ולהשתמש ב-context כמו RAM. נשמע נכון. זה גם בערך מה שרוב ה-frameworks מציעים היום כ-long-term memory.
הבעיה, לפי רולדן, היא discoverability. הסוכן מגיע למידע דרך מחזורים של grep, read, ושוב grep. וכל מחזור כזה מפספס ניואנסים. הקובץ קיים, הכלל כתוב בו, אבל ה-agent לא חיפש את המילה הנכונה.
הצעד הבא בתעשייה ידוע: vector DB או knowledge graph. Patronus, דאטאייקו ו-Turing Post מתארים את זה כמעט אותו דבר: long-term memory נשמר ב-store חיצוני ונשלף ל-context בזמן inference. לעובדות זה עובד יפה. לכלל של התאריכים, לא.
הסיבה האמיתית: הכלל לא דומה לשום שאילתה
פה הפוסט של רולדן הכי חד. הוא מפריד בין זיכרון של עובדות לבין procedural memory, הזיכרון של איך עושים משהו. הדוגמה שלו: אמרתם ל-agent לפרמט תאריכים תמיד כ-YYYY-MM-DD. אחר כך ביקשתם summarize this spreadsheet. חיפוש וקטורי על השאילתה הזו מחפש סביב spreadsheet ו-summarize. הכלל מדבר על dates ו-format. במרחב ה-embeddings הם רחוקים, והכלל לא נשלף.
בקיצור: הכלל שאתם הכי צריכים הוא בדיוק זה שלא דומה לשאלה. retrieval סמנטי לא נכשל פה בגלל באג. הוא נכשל by design.
גם בטבלה של Patronus זה כתוב, בלי לעשות מזה עניין: procedural memory נשמר לרוב כ-system prompt מעודכן או כ-workflow שאפשר להריץ. כלומר לא נשלף. נטען.
ארבעה חודשים אחרי, מישהו מדד את זה
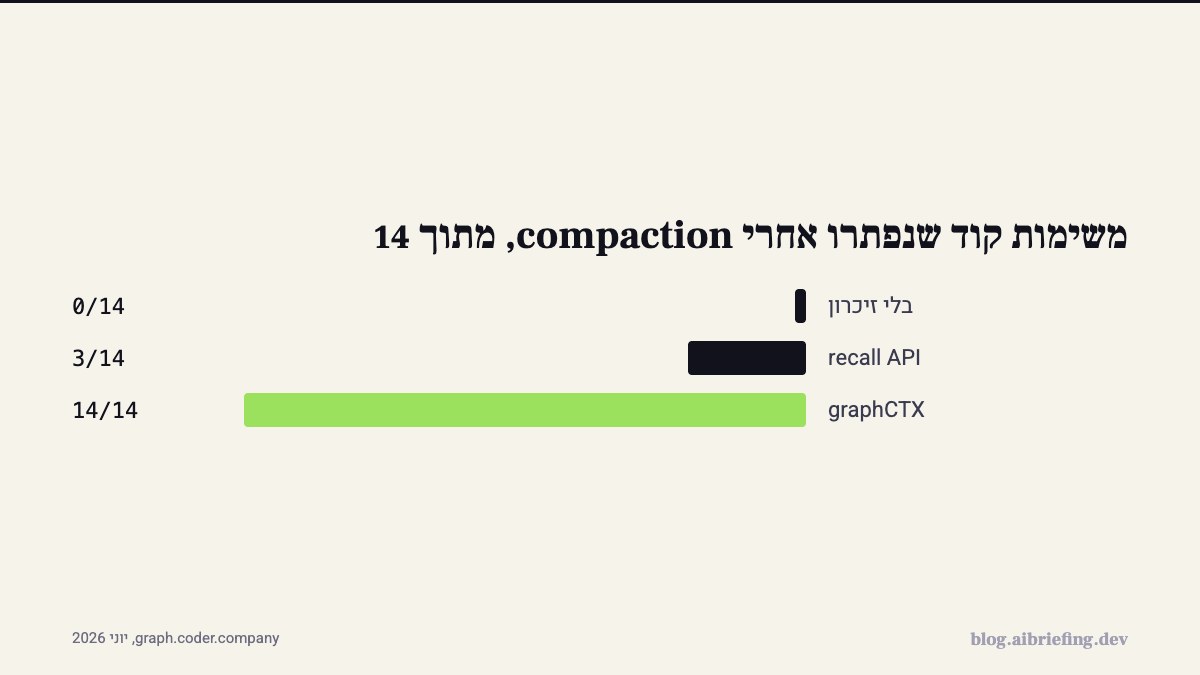
ביוני 2026 עלו ל-HN שני פרויקטים שתוקפים את אותה בעיה מכיוונים שונים. graphCTX, שכבת זיכרון ל-coding agents, הריצו eval של 14 משימות קוד אחרי compaction. בלי זיכרון: 0 מתוך 14. עם recall API: 3 מתוך 14. עם graphCTX: 14 מתוך 14. הם קושרים כל fact ל-commit ול-branch במקום לשעון, ומקדמים זיכרון מ-session לזיכרון קבוע רק אחרי evidence gate. ה-lookup המקומי שלהם לוקח בערך 1ms, מול 494ms ב-p50 לחיפוש ב-Supermemory.
YourMemory הולכים לכיוון השני: זיכרון הוא בעיית pruning, לא hoarding. כל זיכרון דועך לפי עקומת אבינגהאוס ונמחק כשהחוזק שלו יורד מתחת ל-0.05. הם מדווחים 89.4% ב-Recall@5 על LongMemEval ו-84% פחות tokens מבוזבזים אחרי 30 sessions.
הסתייגות: כל המספרים פה הם של היוצרים, על ה-eval שלהם. 14 משימות זה מדגם קטן, ואני לא הייתי בוחר כלי לפי זה. מה שמעניין אותי פה זה איך הם מודדים, לא מה יצא.
ובמקביל, הסקר של LangChain על 2026 (יותר מ-1,300 משיבים) מצא ששליש מצביעים על איכות כחסם העיקרי ל-production, וחברות גדולות מזכירות ספציפית ניהול context.
מה לוודא אצלכם לפני שה-agent רץ לילה שלם
קודם כל, תפרידו. כללים פרוצדורליים, כמו פורמטים, conventions ו“לא נוגעים ב-main”, הולכים לקובץ שנטען תמיד: CLAUDE.md, AGENTS.md או ה-system prompt. לא ל-vector store. ה-store הוא לעובדות ולאירועים.
חוץ מזה, תבדקו את זה בטסט ולא בתחושה. אם יש לכם פונקציה שמרכיבה את ה-context, תריצו עליה שאילתות שלא קשורות לכללים ותוודאו שהכללים שם:
import pytestfrom my_agent.context import build_context  # your context builder
PROCEDURAL_RULES = [    "YYYY-MM-DD",    "never push to main",]
UNRELATED_QUERIES = [    "summarize this spreadsheet",    "fix the flaky login test",    "write release notes for v2.3",]
@pytest.mark.parametrize("query", UNRELATED_QUERIES)def test_rules_survive_any_query(query):    ctx = build_context(query)    for rule in PROCEDURAL_RULES:        assert rule in ctx, f"rule {rule!r} missing for query {query!r}"
def test_memory_budget_is_flat():    sizes = [len(build_context("status?", session=n)) for n in (1, 30, 120)]    assert sizes[-1] < sizes[0] * 2, f"memory grows with sessions: {sizes}"
תתאימו את build_context לחתימה שלכם. הטסט השני הוא בדיקת ה-hoarding: אם ה-context ב-session 120 גדול פי שניים מזה של session 1, הזיכרון שלכם אוגר במקום לשכוח.
ועוד שני דברים. תריצו eval אחרי compaction, כמו ש-graphCTX עשו: ב-Claude Code זה /compact, ואז אותה משימה שוב, ותבדקו שהכללים עדיין מיושמים. ותנו לכל fact מקור ותאריך תפוגה, commit או זמן, כדי שיהיה מה למחוק.
200K tokens לא יעזרו לכלל של שורה אחת שיושב במקום שאף שאילתה לא מגיעה אליו.
מקורות
- Show HN: YourMemory, agentic memory is a pruning problem, not a hoarding problem · 2026-06-07
- I accidentally hit SOTA on agentic memory by using AI companions · 2026-06-14
- Agentic Memory Bottlenecks · 2026-02-06
- AI Agent Memory: Types, Architecture & How It Works
- Agentic Memory: Types, Management Strategies, and LangGraph Implementation
- AI Agent Memory: Types and Architectures Explained
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 6 מקורות, ונערך ואושר על ידי קובי אלמוג.