Agentic RAG בפועל: שישה צעדים מחיפוש אחד ללולאה עם תקרה
איך הופכים RAG שמחפש פעם אחת ל-agent שמחפש, בודק ומחפש שוב. eval, שלושה tools, grader, MAX_STEPS ו-router, עם קוד להדבקה.
אחד. זה מספר החיפושים ש-RAG קלאסי עושה, והחיפוש הזה רץ לפני שהמודל הספיק לחשוב על השאלה. Panasiti מריץ אפליקציית RAG ליועצי פנסיה ומס באיטליה: INPS, קרנות פנסיה, חקיקה. ב-11 ביוני 2026 הוא תיאר בדיוק את הקיר הזה:
If the first search misses, the answer is bad and there is nothing the model can do about it.
— Panasiti, How to Build an Agentic RAG with RubyLLM and Rails
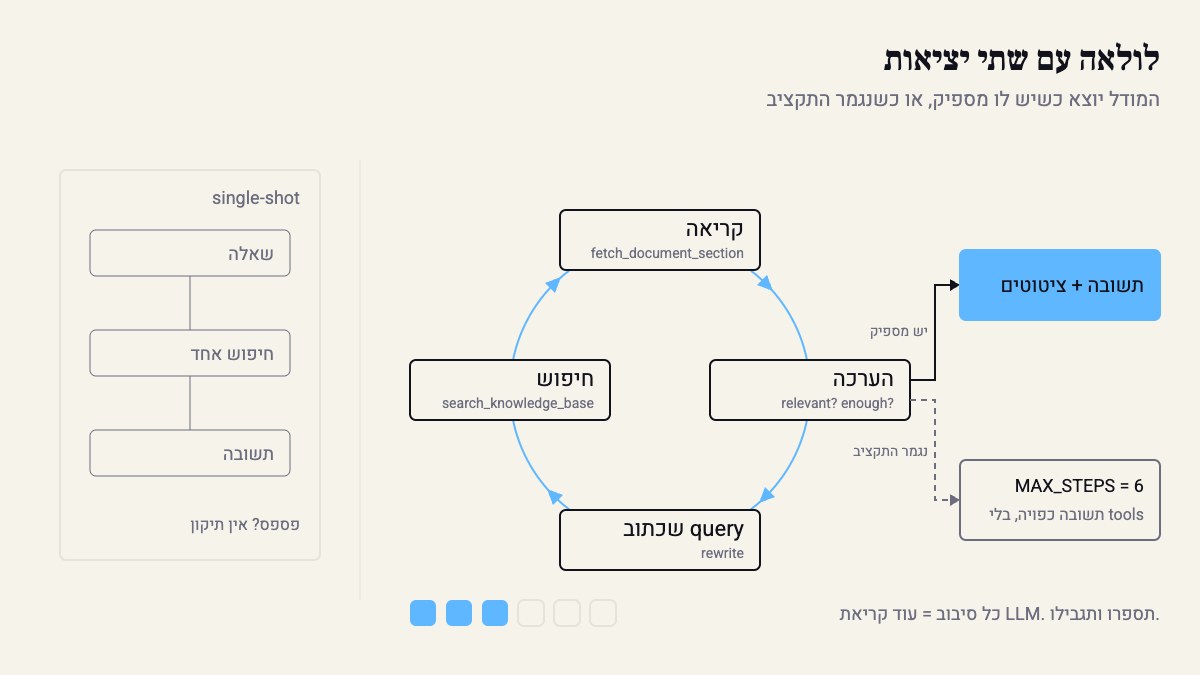
אז הוא בנה את ה-pipeline מחדש כ-agent. שלושה tools, לולאה, והמודל מחליט לבד מתי יש לו מספיק חומר. Rails 8.1, Ruby 3.3, Postgres עם pgvector. בלי LangChain.
בגדול, זה כל הסיפור של agentic RAG. אף אחד לא המציא את המונח, הוא פשוט נדבק. IBM פרסמה עליו explainer בפברואר 2025, NVIDIA ביולי, ומיקרוסופט הפכה אותו לשיעור 5 מתוך 18 בקורס ai-agents-for-beginners. ההגדרה הכי פשוטה: לא דוחפים את תוצאות החיפוש ל-prompt. נותנים למודל את החיפוש כ-tool, והוא קורא לו בלולאה, בודק מה חזר ומחפש שוב אם צריך. זה לא framework ולא מוצר. זו לולאת tool-use שהיעד שלה הוא ה-knowledge base שלכם.
הנה הצעדים, בסדר שבו אני הייתי עושה אותם.
01 · לפני הקוד: 30 שאלות שה-RAG שלכם נופל עליהן
כל סיבוב בלולאה הוא עוד קריאת LLM. אז קודם תוכיחו שיש בעיה שהלולאה פותרת. תוציאו מה-logs שאלות אמיתיות, 30 מספיקות להתחלה, ותתייגו כל אחת לפי סוג הכשל. המקורות מתארים שלושה:
- פער ניסוח. הדוגמה מ-Medium: משתמש שואל “How do I make the graph remember what happened previously?”, והתיעוד מדבר על checkpointers, persistence ו-threads. אין אף מילה משותפת.
- שאלה כפולה. הדוגמה של MachineLearningMastery: “Compare our Q3 2025 sales with Q1 2026 performance and summarize the key risk factors from our latest SEC filing”. חיפוש אחד על כל המשפט מחזיר סלט של chunks שלא עונה על אף חלק.
- הפניות בין מסמכים. חוק שמפנה לסעיף בחוק אחר. בדיוק מה ש-Panasiti פוגש בתחום הפנסיה.
לכל שאלה תסמנו איזה מסמך מכיל את התשובה:
{"q": "How do I make the graph remember what happened previously?", "gold_doc": "persistence.md", "type": "vocab_gap"}{"q": "Compare Q3 2025 sales with Q1 2026 and list risk factors from the latest filing", "gold_doc": ["sales_q3_2025.pdf", "sales_q1_2026.pdf", "10k_2026.pdf"], "type": "multi_part"}עכשיו תריצו את ה-RAG הקיים ותבדקו דבר אחד: האם ה-gold_doc נמצא ב-top-k. אם הוא שם ב-28 מתוך 30, הבעיה שלכם ב-prompt או במודל, לא בחיפוש, ו-agent לא יעזור. אם הוא חסר בשליש מהמקרים, יש לכם בשביל מה לבנות.
02 · שלושה tools, וה-description הוא חצי מהעבודה
Panasiti נתן למודל שלושה tools: search_knowledge_base, fetch_document_section ו-list_documents. החיפוש עצמו hybrid: וקטורי דרך pgvector וה-gem neighbor, ו-full-text דרך pg_search עם מילון איטלקי. כל זה כבר היה לו ב-single-shot. הוא לא החליף את ה-retrieval, רק נתן למודל להפעיל אותו בעצמו.
ה-tool השני הוא החשוב. fetch_document_section נותן למודל לראות chunk חתוך או הפניה לסעיף אחר, ואז לקרוא את כל הסעיף. בלי זה, agentic RAG הוא בסך הכל single-shot שמנסה כמה פעמים.
ועוד דבר: המודל בוחר tool לפי ה-description, לא לפי השם. תכתבו בו שלושה דברים: מה חוזר (כמה chunks, איזה שדות), מתי להשתמש, ומתי לא. “Returns up to 8 chunks with doc_id and section” שווה יותר מכל פסקה על powerful semantic search.
03 · הלולאה, עם תקרה קשיחה
זה מה ש-Panasiti כתב ב-Ruby, בגרסת Python עם ה-SDK של אנטרופיק. מדביקים ומחברים ל-run_tool שלכם, פונקציה שמקבלת שם tool ו-input ומחזירה string:
import osimport anthropic
client = anthropic.Anthropic()MODEL = os.environ.get("RAG_MODEL", "claude-sonnet-4-5")MAX_STEPS = 6
SYSTEM = (    "Answer only from the knowledge base. Search before answering. "    "If results are off-topic, rewrite the query and search again. "    "Cite doc_id and section for every claim. If nothing fits, say so.")
def schema(*fields):    return {"type": "object", "properties": {f: {"type": "string"} for f in fields}, "required": list(fields)}
TOOLS = [    {"name": "search_knowledge_base", "input_schema": schema("query"),     "description": "Hybrid search (vector + full-text). Returns up to 8 chunks with doc_id, section, text. Use short keyword queries."},    {"name": "fetch_document_section", "input_schema": schema("doc_id", "section"),     "description": "Full text of one section. Use when a chunk is cut off or refers to another section."},    {"name": "list_documents", "input_schema": schema(),     "description": "Titles and doc_ids of everything in the knowledge base. Use to check a source exists."},]
def answer(question, run_tool, log=print):    messages = [{"role": "user", "content": question}]    for step in range(1, MAX_STEPS + 1):        last = step == MAX_STEPS        resp = client.messages.create(            model=MODEL, max_tokens=2000, system=SYSTEM, tools=TOOLS,            tool_choice={"type": "none" if last else "auto"},            messages=messages,        )        if resp.stop_reason != "tool_use":            log(f"step={step} done forced={last}")            return "".join(b.text for b in resp.content if b.type == "text")        messages.append({"role": "assistant", "content": resp.content})        results = []        for block in resp.content:            if block.type == "tool_use":                out = run_tool(block.name, block.input)[:6000]                log(f"step={step} tool={block.name} input={block.input} chars={len(out)}")                results.append({"type": "tool_result", "tool_use_id": block.id, "content": out})        if step == MAX_STEPS - 1:            results.append({"type": "text", "text": "Step budget is over. Answer now with what you have and say what is missing."})        messages.append({"role": "user", "content": results})
שני דברים בקוד הזה הם לא קישוט. קודם כל MAX_STEPS. בלי תקרה, שאלה שאין לה תשובה ב-knowledge base תגרום למודל לנסות עוד ועוד ניסוחים. שישה צעדים זו ברירת המחדל שלי, ותכווננו לפי ה-eval מצעד 01. חוץ מזה, הצעד האחרון רץ עם tool_choice מסוג none ועם הוראה מפורשת לענות ולהגיד מה חסר. ככה גם כשנגמר התקציב, המשתמש מקבל תשובה ולא timeout.
ותזכרו את החשבון. כל צעד שולח שוב את כל השיחה, כולל ה-chunks של כל הצעדים הקודמים. צעד 5 משלם שוב על כל מה שנשלף בצעדים 1 עד 4. אז cache_control על ה-system וה-tools, וחיתוך של כל tool_result, כמו ה-[:6000] למעלה.
04 · Evaluate לפני Generate
בלולאה מצעד 03 המודל אמור לשפוט לבד אם מה שחזר רלוונטי. לפעמים הוא עושה את זה, ולפעמים פשוט עונה ממה שיש. Senevirathna ניסח את התיקון הכי טוב ב-Medium: במקום Question → Retrieve → Generate, עושים Question → Retrieve → Evaluate → Decide. ואם ה-evaluate נכשל, יש ארבע אפשרויות: לשכתב את ה-query, לחפש שוב, לפנות למקור אחר, או לעצור ולשאול בן אדם.
בפועל אני מוציא את ה-evaluate מהלולאה הראשית לקריאה נפרדת, עם מודל זול ותשובה ב-JSON. ככה אפשר לבדוק אותו לבד, לראות מתי הוא טועה, ולהחליף אותו בלי לגעת בשאר. זה ה-prompt שאנחנו מריצים, עם שאלת ה-checkpointers מצעד 01. התוצאה נכנסת ללולאה: רק chunks שסומנו relevant נשארים ב-context, ואם enough הוא false, ה-query המוצע הולך לחיפוש הבא.
הדעה שלי: ה-grader הוא הצעד היחיד כאן שבאמת שווה את הכסף. מודל שמחפש שלוש פעמים ולא בודק מה מצא, פשוט מייצר טעות יקרה יותר. תבנו את ה-evaluate קודם, ואת הלולאה אחר כך.
05 · תראו את הצעדים, למשתמש ולעצמכם
Panasiti מזרים ל-browser לא רק את התשובה אלא גם את צעדי ה-agent, דרך Turbo Streams, ואת כל הריצה הוא מריץ ב-background job מחוץ ל-request. המשתמש רואה מה המודל מחפש ואיזה סעיף הוא קורא, ולא בוהה ב-spinner.
אצל Bayer זה עוד יותר מפורש. PRINCE, מערכת agentic RAG למחקר פרה-קליני שהצוות תיאר באתר של מרטין פאולר בסוף ספטמבר 2026, נבנתה עם רשימה ארוכה של דברים סביב המודל: orchestration, גבולות ל-tools, שמירת state, retries, fallbacks, validation, reflection loops, observability ו-human review. הם כותבים שאז עוד לא קראו לזה harness engineering, אבל זה בדיוק מה שזה היה.
תרשמו שורה לכל tool call, משהו כזה:
step=2 tool=search_knowledge_base query="checkpointer thread_id" chunks=8 kept=3
ושלושה מספרים לדשבורד: ממוצע צעדים לשאלה, אחוז השאלות שהגיעו ל-MAX_STEPS, ואחוז ה-chunks שה-grader זרק. אם יותר מ-10% מהשאלות מגיעות לתקרה, הבעיה כמעט אף פעם לא בתקרה. היא ב-descriptions או בחיפוש עצמו.
06 · Router: לא כל שאלה מקבלת agent
רגע, נעצור. ב-eval מצעד 01 רוב השאלות כנראה עברו ב-single-shot בלי בעיה. “What is LangGraph’s StateGraph?” לא צריכה לולאה. היא צריכה חיפוש אחד וזהו.
אז שמים router בכניסה. לא מודל, כלל: שאלה קצרה, בלי compare, בלי שני תאריכים, בלי הפניה לסעיף, הולכת ל-single-shot. כל השאר הולך ל-agent. אם הכלל לא מחזיק, classifier זול. Bayer הלכו רחוק יותר וחילקו את העבודה ל-steps עם context נפרד לכל אחד: research, reflection, writing. כל שלב מקבל רק את מה שהוא צריך, ולא את כל ההיסטוריה.
תריצו את 30 השאלות על שני המסלולים ותשוו שלושה דברים: דיוק, latency ועלות לשאלה. agentic RAG צריך לנצח בדיוק על השאלות הקשות, ולא להפסיד על הקלות.
מה לקחת
- מתחילים מ-eval של שאלות שנופלות, לא מ-framework. אם ה-gold doc כבר ב-top-k, agent לא יעזור.
fetch_document_sectionשווה יותר מעוד ניסיון חיפוש. תנו למודל לקרוא את המסמך, לא רק chunks.- grader נפרד ב-JSON לפני התשובה. ככה יודעים מה נכנס ל-context ולמה.
- לולאה בלי
MAX_STEPSהיא לא agent. היא חשבונית פתוחה.
מקורות
- Bayer's PRINCE: a production agentic RAG system · 2026-06-16
- How to Build an Agentic RAG with RubyLLM and Rails · 2026-06-10
- Save Your Time with These Agentic RAG Patterns · 2026-09-27
- Agentic RAG Explained in 3 Levels of Difficulty · 2026-05-04
- ai-agents-for-beginners | 18 Lessons to Get Started Building AI Agents
- What is Agentic RAG? | IBM
- Traditional RAG vs. Agentic RAG—Why AI Agents Need Dynamic Knowledge to Get Smarter | NVIDIA Technical Blog
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 7 מקורות, ונערך ואושר על ידי קובי אלמוג.