Agentic workflows: מי בוחר את הצעד הבא
מה זה agentic workflow ומה ההבדל מ-agent. איך GitHub מריצה את זה ב-Actions, מה Elastic ו-Pyrefly למדו, ולמה keepalive כל 30 שניות זה בזבוז.
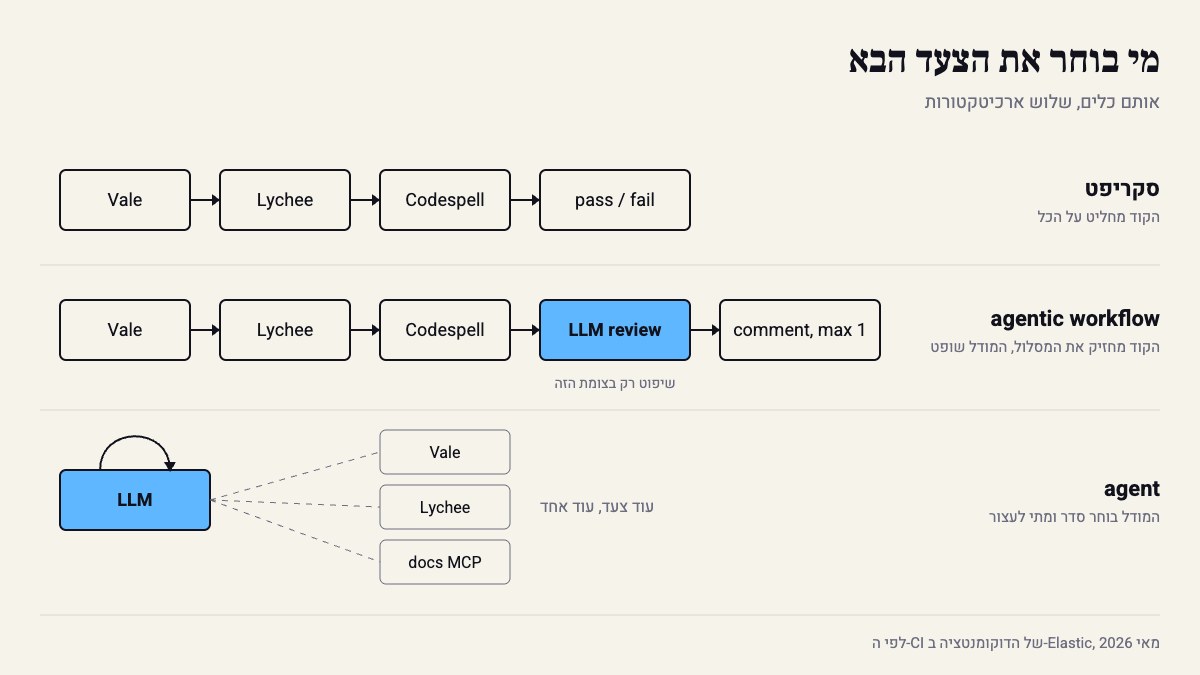
מאי 2026. Fabrizio Ferri-Benedetti, tech writer ב-Elastic, מחבר ל-CI של הדוקומנטציה שלושה כלים משעממים: Vale לסגנון, Lychee ללינקים שבורים, Codespell לשגיאות כתיב. מעליהם הוא שם שלב LLM שמושך את המידע הנכון על המוצר מ-MCP server של הדוקס, ובודק רק מה שהכלים הטיפשים לא יודעים לבדוק. את כל זה מחזיק GitHub Agentic Workflows, פרויקט של GitHub Next שעוד לא היה GA. הסיכום שלו: “mostly works, with caveats”.
ב-28 באוקטובר GitHub הוציאה את זה ל-GA. בהכרזה יש ציטוט מ-Accenture: ירידה מבערך 11,000 שגיאות production ביום לפחות מ-1,000, ו-AI שכותב 91% מה-commits של הצוות. המספרים שלהם, על הצוות שלהם, בלי מילה על איך מדדו. אבל הם כן מסבירים למה כולם מדברים על המונח הזה בכל standup.
מאיפה זה הגיע, ומה זה לא
אנדרו נג דחף את המונח במרץ 2024, בהרצאה ב-Sequoia ובסדרת מכתבים ב-The Batch. הוא הציע ארבעה דפוסים: reflection, tool use, planning, multi-agent. והמספר שגרם לכולם להקשיב: GPT-3.5 בתוך לולאה הגיע ל-95.1% ב-HumanEval, מול 67% של GPT-4 בניסיון אחד.
בדצמבר 2024 אנטרופיק חידדה את זה בפוסט Building effective agents. workflow זה LLM וכלים שהקוד מתזמר במסלולים קבועים מראש. agent זה מערכת שבה המודל מחליט בעצמו על המסלול ועל הכלים.
בגדול, השאלה היא מי בוחר את הצעד הבא. בסקריפט, הקוד. ב-agent, המודל. ב-agentic workflow הקוד מחזיק את המסלול, והמודל מקבל שיפוט רק בצמתים מסוימים: לסווג issue, להבין למה ה-CI נפל, להחליט אם שינוי ב-API שובר משהו בדוקס.
מה זה לא: זה לא “AI שעובד בלי בני אדם”. IBM ו-Salesforce כותבים על “minimal human intervention”. בפועל, מה ש-GitHub שלחה ל-GA בנוי הפוך: ה-agent רץ עם הרשאות קריאה, וכל כתיבה ל-repo עוברת דרך safe outputs שהוגדרו מראש. ועוד דבר: אם אפשר לכתוב את המסלול כ-if/else, זה לא agentic workflow. זה סקריפט, ועדיף ככה.
איך זה נראה ב-GitHub: Markdown שמתקמפל ל-YAML
כותבים את ה-workflow בשפה טבעית בקובץ Markdown, עם frontmatter של trigger, הרשאות וכלים. הפקודה gh aw compile מייצרת ממנו Actions YAML רגיל, אז הוא רץ על ה-runners וה-policies שכבר יש לכם בארגון. המנוע הוא Copilot, או coding agent אחר שאתם מביאים.
---on:  pull_request:    paths: ["docs/**"]permissions:  contents: read  pull-requests: readengine: claudetools:  bash: ["vale", "lychee", "codespell"]safe-outputs:  add-comment:    max: 1---
# Docs review
1. Run vale, lychee and codespell on the changed files. Treat their output as ground truth.2. Review only the changed files for what those tools cannot catch: wrong product facts, broken steps, missing prerequisites.3. Do not repeat findings the tools already reported.4. Post one comment with at most 5 findings, each with file and line. If nothing is real, say so in one line.
ואז:
gh extension install github/gh-awgh aw compilegit add .github/workflows/docs-review.md .github/workflows/docs-review.lock.ymlשני דברים בקובץ הזה עושים את רוב העבודה. max: 1 מגביל את ה-agent לתגובה אחת, לא חמש-עשרה. ושורה 3 ב-prompt אומרת לו לא לחזור על מה שה-linters כבר מצאו. בלי זה תקבלו PR מוצף בהערות על פסיקים.
הדוגמה של Elastic: רובוטים טיפשים קודם
Ferri-Benedetti מסביר למה הוא מערבב את שני הסוגים:
Mixing dumb robots with smart ones […] helps reduce false positives while ensuring complete scan coverage at the same time.
— Fabrizio Ferri-Benedetti, passo.uno, מאי 2026
הכלים הדטרמיניסטיים נותנים כיסוי מלא: כל קובץ, כל לינק. ה-LLM מסנן רעש ותופס מה שאין לו חוק. כל צד סוגר את החור של השני.
רגע, אז פשוט לחבר ל-agent כל כלי בדיקה שיש? לא בדיוק. Conner Nilsen מצוות Pyrefly הציג ב-PyCon US 2026 ניסוי: agents שפותרים משימות עם type checker ובלי. ב-codebase עם type coverage גבוה, ה-success rate עלה מבערך 80% ל-84%, עם פחות צעדים ופחות זמן. ב-codebase עם coverage נמוך, אין שיפור. ה-agent התחיל לתקן imports ו-type signatures בקוד שכן, במקום לפתור את המשימה.
הדעה שלי: זה הממצא הכי שימושי שקראתי השנה על agentic workflows. כלי דטרמיניסטי רועש הוא לא עוד context, הוא משימה חלופית שה-agent ישמח לעשות במקומכם. לפני שאתם מחברים linter ל-workflow, תנקו אותו עד שהוא מוציא אפס על main.
ה-pause שאוכל את ה-cache
עוד בעיה שלא רואים בדמו. ה-workflow שולח בקשה, ואז מחכה: ל-build, לטסטים, לאישור של בן אדם. עשר דקות. ה-prompt cache כבר מת, והבקשה הבאה משלמת מחיר מלא על prefix ענק. ב-cache hit משלמים בערך עשירית ממחיר הקלט, אז ההפרש מורגש.
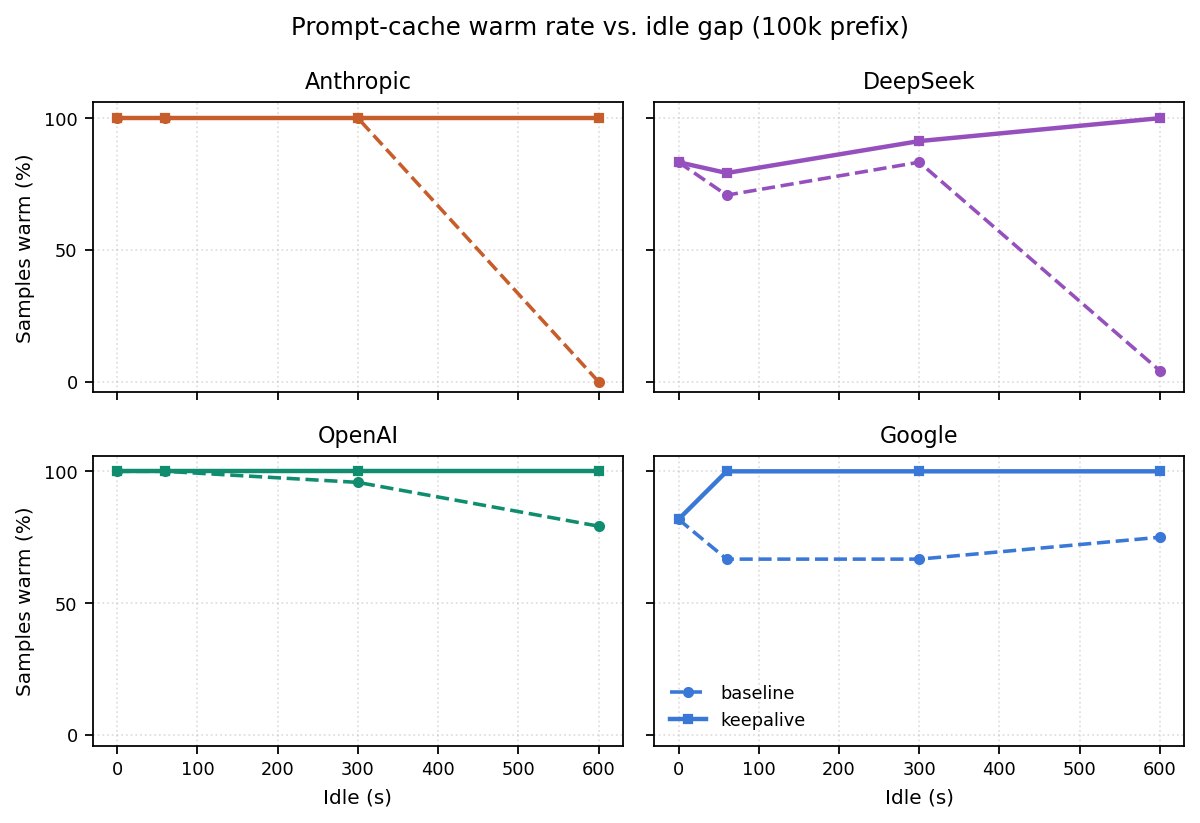
הפתרון המקובל הוא keepalive: לשלוח שוב את אותו prefix כל 30 שניות כדי לרענן את ה-TTL. mempko מדד את זה באמת, על אנטרופיק, OpenAI, Gemini ו-DeepSeek, שלוש ריצות עם timestamp על כל קריאה. התוצאה: 30 שניות זה פי 8 יותר מדי. המרווח הנכון הוא בערך 4 דקות, וזה מסתדר עם TTL ברירת המחדל של אנטרופיק, 5 דקות. ובפאוזה של עשר דקות, רק ספק אחד מתוך ארבעה חסך כסף עם keepalive: אנטרופיק. ב-DeepSeek זה קונה latency, לא כסף. ב-OpenAI וב-Gemini זה לא קונה כלום.
בקיצור, keepalive זו החלטה per-provider. ה-workflow על קלוד ומחכה ל-CI ארוך? ping כל 4 דקות. על OpenAI או Gemini, תוותרו.
מה לנסות השבוע
- תבחרו משימה אחת שחוזרת בכל PR ובן אדם עושה היום בעין: triage של issues, ניתוח כשל ב-CI, review לדוקס. רק אחת.
- תכתבו קודם את החלק הדטרמיניסטי. כל מה ש-linter, schema או טסט יודעים לבדוק, הם בודקים. ה-LLM מקבל רק את השארית.
- תוודאו שהכלים האלה מוציאים אפס על main לפני שה-agent רואה אותם. אחרת הוא יעבוד עליהם במקום על ה-PR.
- הרשאות
contents: read, וכל פלט דרךsafe-outputsעםmax. - תמדדו בשבוע הראשון: כמה הערות נסגרו כ-false positive, כמה דקות review נחסכו, כמה עולה ריצה.
- יש המתנה ארוכה באמצע והמודל הוא קלוד? keepalive כל 4 דקות. לא 30 שניות.
אם אתם לא יכולים להצביע על הצומת שבה המודל שופט ולהגיד למה דווקא שם, אין לכם agentic workflow. יש לכם agent עם YAML מסביב.
מקורות
- What I've learned designing agentic workflows for docs · 2026-05-11
- GitHub Agentic Workflows are generally available · 2026-11-03
- Agentic Workflow's Cache Keepalive Costs 8x Too Much · 2026-07-22
- Type Checking in Agentic Workflows – Conner Nilsen – PyCon US 2026 Typing Summit · 2026-06-12
- What are Agentic Workflows? | IBM
- What Are Agentic Workflows? | Salesforce
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 6 מקורות, ונערך ואושר על ידי קובי אלמוג.