Context engineering: איך אנטרופיק מחקה 80% מה-prompt של Claude Code ולא הפסידה כלום
אנטרופיק מחקה יותר מ-80% מה-system prompt של Claude Code בלי ירידה ב-evals. מה השתבש ב-context, ואיך לבדוק את ה-CLAUDE.md שלכם השבוע.
- 01תריצו /doctor ב-Claude Code ותצמצמו כל skill ו-CLAUDE.md שהוא מסמן
- 02חפשו הוראות סותרות בין system prompt, skills ו-CLAUDE.md, ותשאירו אחת
- 03בלי eval לפני ואחרי, אל תמחקו ואל תוסיפו שום חוק
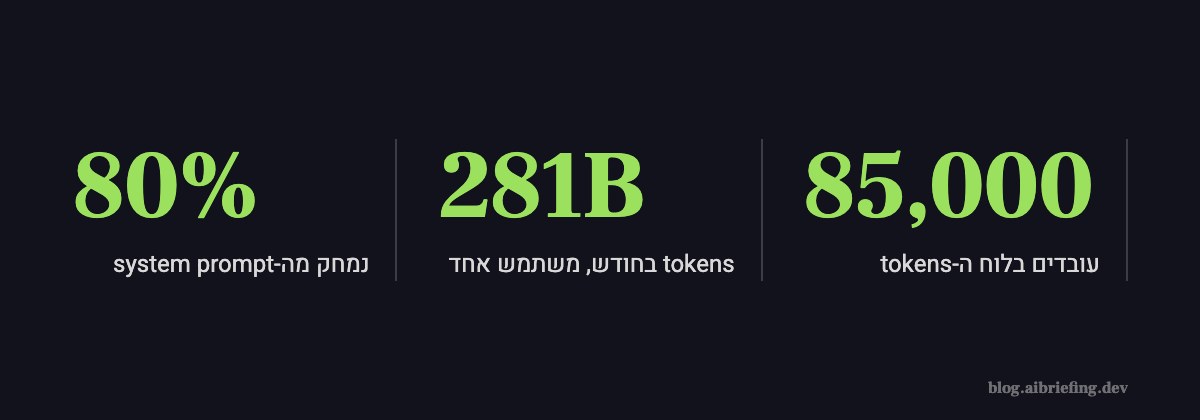
80%. זה החלק של ה-system prompt של Claude Code שאנטרופיק מחקה כשעברו ל-Opus 5 ול-Fable 5. ב-24 ביולי 2026 הם כתבו את זה בבלוג של Claude, ובאותו משפט הוסיפו שלא ראו שום ירידה מדידה ב-coding evals שלהם.
רגע, תחשבו מה זה אומר. ארבע מכל חמש שורות שהצוות שבונה את הכלי כתב בשביל קלוד לא עשו כלום. או גרוע מזה, הפריעו. זה סיפור על איך הגיעו לשם, וסביר שאותו דבר קורה עכשיו ב-CLAUDE.md שלכם.
יוני 2025 עד אפריל 2026: כולם מוסיפים context
המונח נדבק ביוני 2025. טובי לוטקה, ה-CEO של שופיפיי, הגדיר את זה כ-“the art of providing all the context for the task to be plausibly solvable by the LLM”, וקרפטי נתן לזה +1 מול prompt engineering. פיל שמיד ואחרים הפכו את זה לדיסציפלינה: system prompt, tools, היסטוריה, memory, retrieval. כל מה שנכנס ל-context window בכל קריאה.
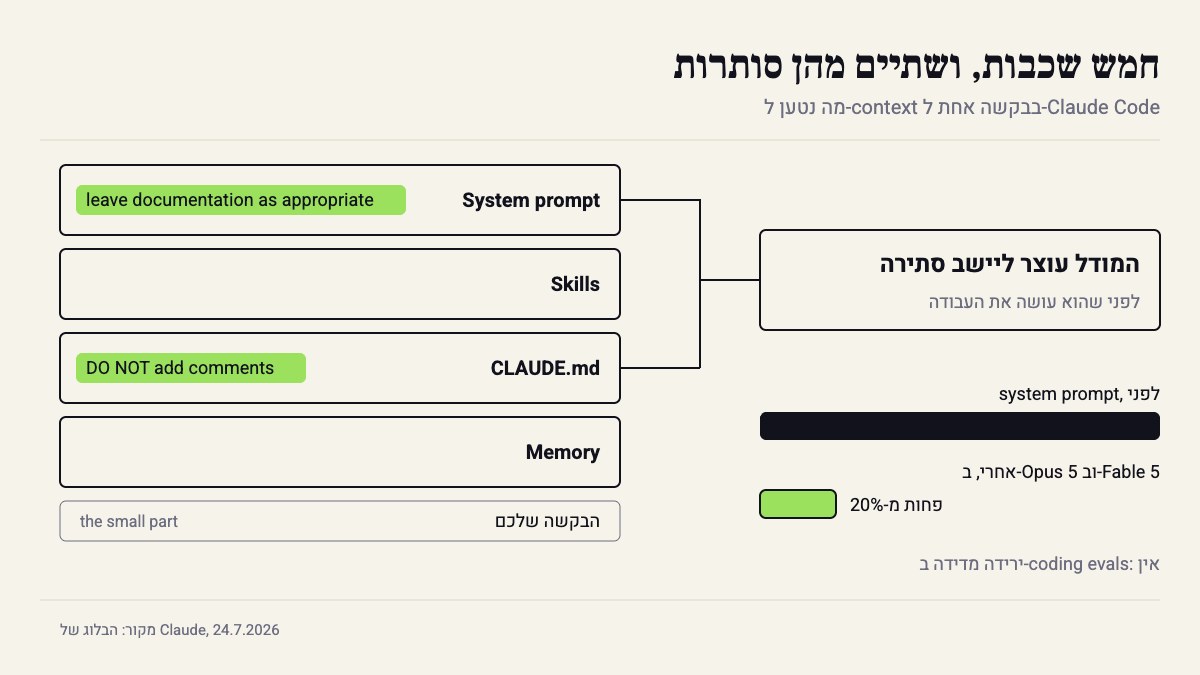
ב-Claude Code זה נראה ככה: ה-prompt שאתם מקלידים הוא חלק קטן. מסביבו נטענים system prompt, Skills, קבצי CLAUDE.md ו-memory. כל שכבה כתב מישהו אחר, בזמן אחר, בשביל בעיה אחרת.
ובמקביל, התעשייה דחפה בדיוק לכיוון ההפוך מדיוק. באפריל 2026 עובד ב-Meta הקים לוח פנימי בשם “Claudeonomics” שדירג כ-85,000 עובדים לפי כמות ה-tokens שעברו דרכם. המקום הראשון עמד על 281 מיליארד tokens בחודש. Meta הורידה את הלוח תוך כמה ימים, אבל המסר כבר עבר: יותר tokens זה יותר עבודה. לזה קראו tokenmaxxing.
בקשה אחת, שתי הוראות סותרות
אנטרופיק ישבו וקראו transcripts של השימוש הפנימי שלהם ב-Claude Code. זה מה שהם מצאו:
“we see several conflicting messages in a single request like ‘leave documentation as appropriate,’ or ‘DO NOT add comments’ as our system prompt, skills, and user requests clash with each other.” — אנטרופיק, The new rules of context engineering for Claude 5 generation models, יולי 2026
בקשה אחת. שלוש שכבות. שתי הוראות שאי אפשר לקיים ביחד. ה-system prompt אומר דבר אחד, skill שמישהו כתב לפני חצי שנה אומר את ההפך, והבקשה של המשתמש מושכת לכיוון שלישי.
מבחוץ זה לא נראה כמו באג
וזה החלק הערמומי. אנטרופיק כותבים שבדרך כלל קלוד כן מגיע לתשובה הנכונה, כי הוא מבין מה המשתמש רוצה. אבל הוא צריך לחשוב יותר על ההוראות החופפות והסותרות לפני שהוא מחליט מה לעשות.
אין exception. אין טסט שנופל. בפועל אתם רואים agent שקצת יותר איטי, קצת פחות עקבי, ולפעמים בוחר בהוראה הלא נכונה מבין השתיים. ואתם מאשימים את המודל.
מה שכן, יש סימן אחד שקל לפספס: הבעיה גדלה עם הזמן. כל skill חדש וכל שורה ב-CLAUDE.md הם עוד הזדמנות לסתירה. אף אחד לא כותב הוראה סותרת בכוונה. היא פשוט מצטברת.
התיקון הראשון: עוד חוק
ההרגל הטבעי, וגם מה שאנטרופיק עצמם עשו, הוא לענות על כל התנהגות רעה בחוק. המודל הוסיף הערות מיותרות? DO NOT add comments. המודל לא תיעד? leave documentation as appropriate. כל חוק כזה הגיוני ביום שכתבו אותו. הם עצמם כותבים שהחוקים האלה “were once needed to avoid worst case scenarios”. ביחד הם הפכו לרעש.
בגדול, זה tokenmaxxing בגרסת ה-prompt: מודדים כמה כיסינו, לא כמה עזרנו. Faros ניסחו את זה הכי טוב במדריך שלהם: המטרה היא לא למקסם context, אלא להפוך אותו לרלוונטי ושמיש.
הסיבה האמיתית: המודל התקדם, ה-context לא
השורש לא היה הוראה גרועה אחת. החוקים נכתבו למודלים של פעם. דור 5 של קלוד מסתדר עם שיקול דעת ועם ההקשר מסביב, והחוקים שנועדו להגן מפני המקרה הגרוע פשוט חוסמים אותו. הכותרות בפוסט שלהם אומרות את זה בלי עדינות: Then: Give Claude rules. Now: Let Claude use judgement.
חוץ מזה, CLAUDE.md שימש פעם מחסן לכל דבר: memory, מידע, הנחיות. היום יש ל-Claude Code גם memory, artifacts ו-skills, ולכל אחד מהם דרך משלו לטעון context רק כשצריך. קובץ אחד ענק שנטען בכל בקשה כבר לא הכלי הנכון.
אז הם מחקו. יותר מ-80%. ומדדו. וזה החלק שאנשים מפספסים כשהם קוראים רק את הכותרת: הם יכלו למחוק רק כי היה להם eval לפני ואחרי.
מה לבדוק אצלכם השבוע
קודם כל, תריצו /doctor בתוך Claude Code. אנטרופיק הכניסו לשם את ה-best practices מהפוסט, והוא מסמן skills וקבצי CLAUDE.md שכדאי לצמצם.
חוץ מזה, תספרו. הסקריפט הזה עובר על כל קבצי ה-CLAUDE.md וה-SKILL.md ב-repo ובתיקייה הגלובלית, ומראה כמה מילים וכמה חוקים בצעקות יש בכל אחד:
#!/usr/bin/env bash# כמה מילים וכמה חוקים בצעקות יש בכל קובץ contextfind . ~/.claude \( -name 'CLAUDE.md' -o -name 'SKILL.md' \) \ -not -path '*/node_modules/*' 2>/dev/null |while read -r f; do words=$(wc -w < "$f" | tr -d ' ') rules=$(grep -cE 'NEVER|ALWAYS|DO NOT|MUST|IMPORTANT' "$f") printf '%6s words %3s rules %s\n' "$words" "$rules" "$f"done | sort -rnמה לחפש בפלט:
- הקבצים בראש הרשימה. כל מילה שם נטענת בכל בקשה, גם כשהיא לא רלוונטית למשימה.
- עמודת ה-rules. כל NEVER או ALWAYS הוא כנראה חוק שנכתב אחרי תקלה. תשאלו אם התקלה הזו עוד קורה עם המודל שאתם מריצים היום.
- אותו נושא בשני מקומות. תריצו
grep -ri commentעל כל הקבצים ותראו אם ה-system prompt, skill ו-CLAUDE.md אומרים דברים שונים. אם כן, תשאירו אחד.
ואז הכלל שהופך את זה מניקיון לשיפור: תריצו את אותן 10–20 משימות לפני ואחרי המחיקה. משימות אמיתיות מה-backlog, אותה הגדרת הצלחה, אותו מודל. בלי מספר לפני ואחרי אתם לא מצמצמים context, אתם מנחשים.
הסתייגות: ה-80% הם של אנטרופיק, על ה-coding evals שלהם ועל המודלים הכי חדשים שלהם. אם אתם עדיין על מודל ישן יותר או על מודל פתוח, חלק מהחוקים האלה כנראה עוד עושים עבודה. אני לא הייתי מוחק שורה בלי eval משלי.
השיפור הכי זול שאפשר לתת ל-agent השבוע הוא מחיקה. אבל רק אם אתם יודעים למדוד מה איבדתם.
מקורות
- The new rules of context engineering for Claude 5 generation models · 2026-07-25
- Context engineering: shifting from "tokenmaxxing" to deliberate curation · 2026-06-26
- Context Engineering for AI Agents Explained - a simple overview of the basics
- Context Engineering Guide for Developers
- Context Engineering: A Practical Guide for AI Agents (2026) | Sourcegraph
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.