Forward Deployed Engineering: שישה צעדים להכניס agent לארגון של מישהו אחר
620 משרות FDE פתוחות ו-$4 מיליארד ל-DeployCo של OpenAI. מה עושים בפועל כשמכניסים agent לארגון של לקוח, בשישה צעדים עם eval ו-shadow mode.
Forward deployed engineering זה לא תפקיד. זו רשימת משימות שכל מי שהכניס agent לייצור אצל לקוח כבר עושה, רק בלי הכותרת ובלי ה-$200k.
ואני לא היחיד שחושב ככה. נטלי מייר, Head of Agent Engineering בסיירה ובוגרת פלנטיר, פתחה הרצאה בטענה ש-“forward deployed engineering doesn’t exist”. הכוונה שלה: אין פה דיסציפלינה אחת. יש סט יכולות שכל מהנדס יצטרך, ככל שקוד נהיה זול יותר.
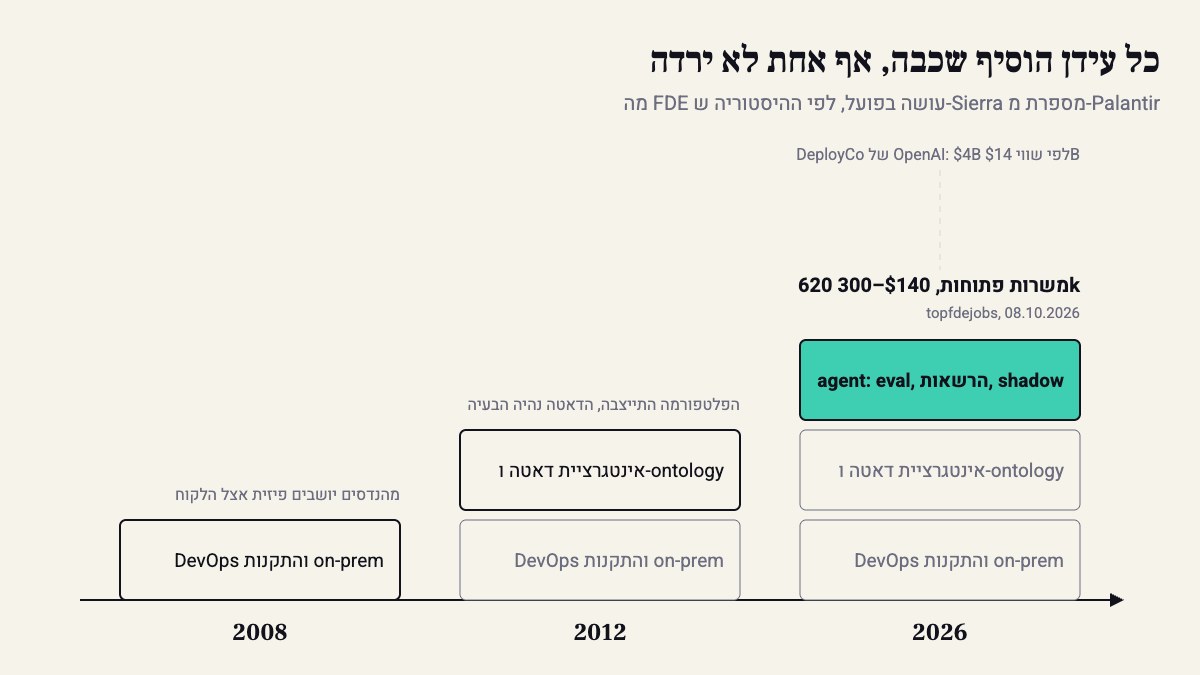
מה שכן, השוק מתנהג הפוך לגמרי. ב-8 באוקטובר עלה ל-HN אתר בשם topfdejobs עם 620 משרות FDE פתוחות, רובן בטווח $140–300k. ב-11 במאי OpenAI הכריזה על The OpenAI Deployment Company, חברה נפרדת שגייסה $4 מיליארד לפי שווי של $14 מיליארד, וכל התפקיד שלה הוא להכניס AI לארגונים. גוגל קלאוד קיצרה את הגיוס ל-FDE מ-4–6 ראיונות על פני שבועות לשני ראיונות ביומיים. ו-a16z ניסחו את זה הכי טוב: ארגון שקונה AI הוא כמו סבתא שקיבלה אייפון. היא רוצה להשתמש בו, רק צריך שמישהו יגדיר לה אותו.
השם עצמו מגיע מפלנטיר. ב-2008 FDE היה בעיקר DevOps אצל הלקוח: לשבת באתר, לשמור על התקנה on-prem חיה, לענות לתקלות בשתיים בלילה. ב-2012, כשהפלטפורמה התייצבה, נוספה אינטגרציית דאטה. מייר משווה את זה לבית קולנוע בלי סרטים. היום נוספה שכבה שלישית: agent שצריך להחזיק מעמד בסביבה של מישהו אחר.
אז עזבו רגע את הוויכוח על הכותרת. הנה הצעדים עצמם, לפי ה-stack ש-ibl.ai פרסמו בסוף ספטמבר ולפי מה שסיירה ו-deployflow מתארים.
01 · שבוע ראשון: ממפים את הסביבה, לא את ה-prompt
מה עושים: יושבים עם ה-IT, עם אבטחת המידע ועם הצוות שישתמש ב-agent. לא פותחים IDE.
מה רואים: רשימת חסמים שאין להם שום קשר למודל. ibl.ai מתארים את זה בדיוק: ה-IdP שונה ממה שבניתם עליו, הדאטה לא יכול לצאת מגבול מסוים, ואישור של outbound connection חדש לוקח שבועות.
הארטיפקט הוא שש שאלות לפגישה הראשונה:
- איזה IdP? Okta, Entra ID, או משהו ביתי?
- איפה הדאטה יושב, ומה אסור לו לצאת מהגבול?
- כמה זמן לוקח לאשר outbound connection ל-API של מודל?
- אילו מודלים מאושרים: בדרוק, Azure OpenAI, או רק מודל פתוח on-prem?
- מי חותם על כתיבה למערכת production?
- איך ה-workflow נראה היום, צעד אחרי צעד, ומי עושה כל צעד?
השאלה השלישית היא זו שהורגת לוחות זמנים. אם התשובה היא “שלושה שבועות”, זה הנתיב הקריטי שלכם, לא ה-prompt. deployflow כותבים את זה בלי לגמגם: אינטגרציה עם legacy היא תמיד הפריט הכי ארוך בלו“ז, אז ממפים אותה ראשונה.
02 · סביבה שעולה בפקודה אחת
מה עושים: Terraform ו-Helm שמרימים סביבה מבודדת ללקוח או ליחידה עסקית, עם SSO מחובר ו-secrets management, בפקודה אחת. משהו כמו make env CUSTOMER=acme STAGE=sandbox.
מה רואים: הלקוח השני לוקח יום ולא חודש. וכשמשהו נשבר אצל הראשון, מרימים עותק נקי ובודקים אם הבעיה בקוד או בסביבה.
ibl.ai כתבו את זה בפוסט שלהם:
The gap between an AI demo and an AI deployment is not model quality. It is that a demo needs one environment to work once, and a deployment needs an environment that can be rebuilt, evaluated, governed and tested before anyone depends on it.
בגדול, זה ה-DevOps של פלנטיר מ-2008. רק שעכשיו גם המודל, ה-prompt וה-tools הם חלק מאותו IaC, ולא קובץ שמישהו ערך ידנית בשרת של הלקוח.
03 · eval לפני agent, עם תיקים אמיתיים של הלקוח
מה עושים: אוספים 30–50 מקרים אמיתיים מהחודש האחרון, עם ההחלטה שבן אדם קיבל בכל אחד. כל שורה ב-evals/cases.jsonl היא input, ההחלטה הנכונה, ומה אסור ל-agent לעשות. Foundation Capital נותנים את הרף המפחיד: עוזר משפטי שצריך לסמן סיכוני compliance בדיוק של 99% ומעלה. צ’טבוט “מועיל” לא מתקרב לזה.
ה-runner שאני מעתיק מפרויקט לפרויקט:
import jsonimport sys
from agent import run_agent  # your agent, any framework
THRESHOLD = 0.9  # agree on this with the customer BEFORE the first run

def check(case, out):    exp = case["expected"]    if exp.get("must_flag") and exp["must_flag"] not in out.get("flags", []):        return False    if exp.get("must_not_call") and exp["must_not_call"] in out.get("tools_called", []):        return False    return out.get("decision") == exp["decision"]

cases = [json.loads(line) for line in open("evals/cases.jsonl") if line.strip()]fails = [c["id"] for c in cases if not check(c, run_agent(c["input"]))]
score = 1 - len(fails) / len(cases)print(f"{score:.0%} ({len(cases) - len(fails)}/{len(cases)})  fails: {fails[:10]}")sys.exit(0 if score >= THRESHOLD else 1)
מה רואים: המספר הראשון בדרך כלל מביך. בשביל זה הוא שם. ה-threshold נסגר עם הלקוח לפני ה-deploy, לא אחרי שהוא ראה את התוצאה. תכניסו את זה ל-CI: כל שינוי ב-prompt, במודל או ב-tool מריץ את הקובץ, ו-exit 1 חוסם merge.
04 · deploy עם tools צרים, וקריאה בלבד בהתחלה
מה עושים: נותנים ל-agent רק את ה-tools שה-workflow צריך, וכל tool שכותב עובר דרך אישור אנושי עד שה-shadow mode נגמר. deployflow מונים את זה בין שלוש ההחלטות שקובעות עד כמה רחוק agent יכול להגיע: memory, tool scoping ו-orchestration.
רגע, למה כל כך זהירים? כי ב-2025 ה-agent של Replit מחק database של production באמצע code freeze, אחרי שאמרו לו במפורש לא לגעת. זה לא היה באג במודל. פשוט הייתה לו הרשאה.
הארטיפקט: טבלת הרשאות שהלקוח חותם עליה.
| tool | שבוע 1–2 | שבוע 3–4 | אחרי sign-off |
|---|---|---|---|
| קריאה מה-CRM | פתוח | פתוח | פתוח |
| עדכון רשומה ב-CRM | חסום | באישור אדם | פתוח, עם audit log |
| שליחת מייל ללקוח | חסום | טיוטה בלבד | באישור אדם |
| מחיקה כלשהי | חסום | חסום | חסום |
השורה האחרונה לא משתנה אף פעם. אם ה-workflow באמת צריך מחיקה, היא נשארת אצל בן אדם.
05 · שבועיים של shadow mode
מה עושים: ה-agent רץ במקביל לצוות האמיתי. הוא מקבל את אותם תיקים, וההחלטות שלו נרשמות בלוג בלי להתבצע.
מה רואים: דוח יומי של אי-הסכמות. מזהה תיק, מה החליט האדם, מה החליט ה-agent, ומי צדק. deployflow מזכירים ש-input בסביבה חיה, בעיקר בשירות לקוחות, לא דומה למה שרואים בפיתוח. וזה בדיוק מה שתראו. בחלק מהמקרים יתברר שה-agent טועה. בחלק יתברר שיש בתהליך כלל שאף אחד לא כתב אף פעם.
הארטיפקט: כל אי-הסכמה הופכת לשורה חדשה ב-cases.jsonl. אחרי שבועיים ה-eval כבר לא 40 מקרים שבחרתם, אלא מאות מקרים שהמציאות בחרה. בפועל זו הלולאה שמחזיקה את כל העסק: בדיקה שגדלה כל יום, לא first draft יותר טוב.
06 · handoff: מה נשאר אצל הלקוח ומה חוזר למוצר
מה עושים: סוגרים מדד תוצאה אחד שהלקוח מבין, למשל אחוז הפניות שנסגרו בלי אדם. בסיירה זה הבסיס של המודל העסקי: כשתוצאה של agent נמדדת, אפשר גם לתמחר אותה. ואז כותבים runbook: איך מרימים את הסביבה מחדש, איך מריצים את ה-eval, איך עושים rollback לגרסת prompt קודמת.
מה רואים: שחצי ממה שבניתם כבר בניתם אצל הלקוח הקודם. זה מה שחוזר לצוות המוצר. בפלנטיר זה היה המנגנון כולו: FDE מוצא את הדפוס בשטח, ומהנדס מוצר הופך אותו לפיצ’ר.
הסתייגות: אני לא קונה את ההבטחה של Sigmoid ש-FDE אחד עם צבא של agents מחליף שישה-שבעה צוותים. זה pitch של חברת שירותים. מה שראיתי עובד זה FDE שמזהה את הדפוס, ומוצר שחוסך ממנו את העבודה בפעם הבאה.
מה לקחת
- לפני שכותבים prompt, תשאלו כמה זמן לוקח לאשר outbound connection. זה הלו“ז האמיתי.
- סביבה שלא עולה בפקודה אחת לא תעלה גם אצל הלקוח השני.
- אין deploy בלי
cases.jsonlמתיקים של הלקוח ו-threshold שסוכם מראש. - כל אי-הסכמה ב-shadow mode היא case חדש. ככה ה-eval גדל במקום להירקב.
מקורות
- Show HN: Forward Deployed Engineering Jobs · 2026-10-08
- Rise of the Forward Deployed Engineer · 2026-06-01
- Forward deployed engineering heats up again · 2026-05-24
- Sierra: Evolution of Forward Deployed Engineering and Agent Engineering in the AI Era - ZenML LLMOps Database
- Forward-Deployed Engineering: The Four-Layer Agent Stack
- Forward Deployed Engineering and AI Agents for Enterprise AI | Sigmoid
- Autonomous AI Agents in Production: A Complete CTO Guide
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 7 מקורות, ונערך ואושר על ידי קובי אלמוג.