GraphRAG: שלוש טבלאות ב-Postgres לפני שאתם קונים graph DB
GraphRAG בלי graph DB: שישה צעדים, מ-eval של 20 שאלות, דרך ontology ושלוש טבלאות ב-Postgres, ועד שאילתת retrieval אחת.
רוב הצוותים שאומרים “אנחנו צריכים GraphRAG” צריכים בעצם שלושה דברים: ontology, טבלת edges ושאילתה אחת שיודעת לקפוץ פעמיים. הם לא צריכים graph DB, לא צריכים community detection, ובטח לא את ה-pipeline המלא של מיקרוסופט.
רגע, מאיפה זה בא. RAG רגיל יצא ממאמר של Meta AI במאי 2020: חותכים מסמכים ל-chunks, עושים embedding ומחזירים את ה-top-k הכי דומים. ב-2024 Microsoft Research פרסמו את GraphRAG. ה-LLM מחלץ מהמסמכים entities ו-relationships, בונים מזה knowledge graph, ובזמן שאילתה הולכים על הגרף במקום לחפש טקסט דומה. השם נדבק מהר, ומאז כל ספק של graph DB מוכר אותו.
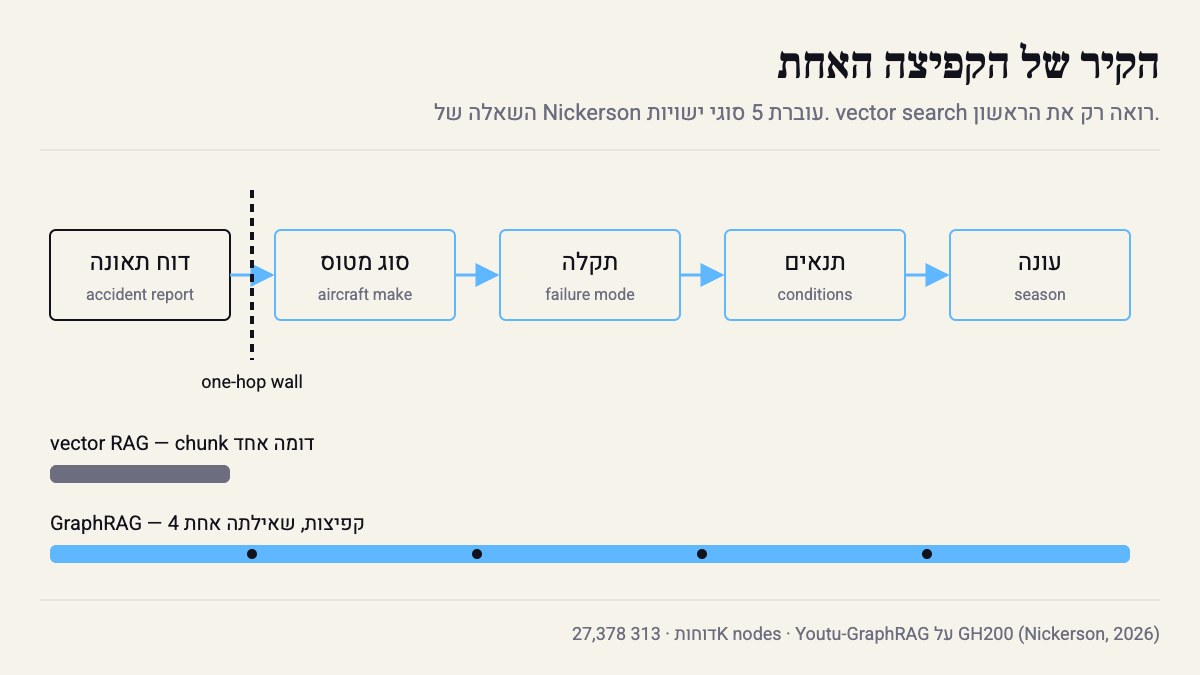
הבעיה שזה פותר אמיתית. ב-Memgraph קוראים לה “one-hop wall”. vector search מוצא chunk שדומה לשאלה, אבל לא מחבר ראיה ממסמך אחד לראיה במסמך אחר. אבל גם המחיר אמיתי. Paul Nickerson הריץ את Youtu-GraphRAG של Tencent (התקבל ל-ICLR 2026) על 27,378 דוחות תאונות תעופה, ויצא לו גרף של 313K nodes. כל החילוץ רץ על Qwen2.5-72B מקומי, על GH200 עם 96GB HBM3. בנפח הזה קריאות API יוצאות, במילים שלו, “prohibitively expensive”. FalkorDB כותבים שקורפוס ארגוני יכול לייצר מיליוני extraction calls. ו-Jai מ-QX, שבונה “company brain” ללקוחות, כתב ב-20 ביולי ש-GraphRAG בפרקטיקה הוא “complete overkill”.
אז ככה אני הייתי עושה את זה, לפי הסדר. כל שלב הוא גם נקודת יציאה. אם הוא לא מצדיק את הבא, עוצרים.
01 · עשרים שאלות לפני שורת קוד
כותבים 20 שאלות אמיתיות, כאלה שמשתמשים כבר שאלו ב-Slack או בתמיכה. ליד כל אחת מסמנים כמה מסמכים צריך כדי לענות, ואיזה קשר מחבר ביניהם.
הדוגמה של Nickerson היא multi-hop קלאסי: “What aircraft make appears most frequently in carburetor icing accidents during winter approaches?” כדי לענות צריך לחבר דוח תאונה ← סוג מטוס ← תקלה ← תנאים ← עונה. שום chunk בודד לא מכיל את התשובה.
מה שתראו בדרך כלל: רוב הרשימה single-hop. וחלק מה-multi-hop הן בעצם אגרגציות ש-GROUP BY פותר בלי שום LLM. הכלל שלי: פחות מחמש שאלות multi-hop מתוך 20, נשארים עם vector RAG ומשפרים chunking.
- id: q07 q: "אילו שירותים נפגעים מה-CVE הזה דרך תלויות?" hops: 2 path: [cve, package, service] expected_docs: [sbom/payments.json, sbom/auth.json]- id: q08 q: "מה מדיניות ה-retention של לוגים?" hops: 1 expected_docs: [policies/logging.md]השדה path הוא לא קישוט. ממנו נבנה את ה-ontology בשלב הבא.
02 · ontology קודם, חילוץ אחר כך
הטעות הכי נפוצה היא לבקש מה-LLM לחלץ “את כל ה-entities”. מה שיוצא זה גרף שבו Person, person, Employee ו-CEO הם ארבעה סוגים שונים, וכל אחד מחובר לחצי מהעולם. Paul Iusztin העביר את זה כהרצאה פעמיים בחודש אחד, וניסח את זה הכי טוב:
GraphRAG isn’t a retrieval algorithm, it’s a data modeling problem. — Paul Iusztin, Decoding AI
גם Youtu-GraphRAG עושה בדיוק את זה, רק עם שם מכובד: schema-guided extraction. הגרף מוגבל מראש לסוגים שרלוונטיים לניתוח. בפועל: 5–8 סוגי entities, 6–10 סוגי edges, לכל edge יש כיוון. ומה שלא מופיע באף path בקובץ השאלות לא נכנס.
ותתייחסו לזמן ברצינות. הדוגמה של Iusztin: Arthur סיפר ל-Felix שבית הקפה האהוב עליו בטימישוארה, ואחרי חודשיים הוא עבר ללישבון. אם אתם דורסים את ה-edge, איבדתם היסטוריה. append-only עם valid_from ו-valid_to, וזהו.
03 · שלוש טבלאות ב-Postgres
לפני שמקימים Neo4j או FalkorDB, תנסו על ה-Postgres שכבר יש לכם. Polygres עלו ל-Show HN ב-7 ביולי בדיוק עם הטענה הזו, וה-engines שמאחוריהם, pgGraph ו-pgContext, פתוחים ועברו 1K כוכבים ב-GitHub. לא צריך את המוצר שלהם כדי להתחיל. צריך pgvector ושלוש טבלאות:
create extension if not exists vector;
create table chunks (  id bigserial primary key,  doc_id text not null,  content_hash text not null unique,  body text not null,  embedding vector(1024));
create table entities (  id bigserial primary key,  type text not null check (type in ('person','team','service','package','cve','incident')),  name text not null,  norm_name text generated always as (lower(trim(name))) stored,  embedding vector(1024),  unique (type, norm_name));
create table edges (  src bigint not null references entities(id),  dst bigint not null references entities(id),  rel text not null check (rel in ('owns','used_by','affects','caused','on_call_for')),  chunk_id bigint not null references chunks(id),  valid_from timestamptz not null default now(),  valid_to timestamptz,  primary key (src, rel, dst, valid_from));
create index on chunks using hnsw (embedding vector_cosine_ops);create index on entities using hnsw (embedding vector_cosine_ops);create index on edges (src) where valid_to is null;
את ה-1024 תתאימו למודל ה-embedding שלכם. ה-unique על (type, norm_name) עושה בדיוק את מה ש-FalkorDB מתארים כ-schema constraints: אין שני nodes ל-“Acme” ול-“acme “. ה-check על type ועל rel הוא ה-ontology משלב 02, אכוף בדאטהבייס. LLM שמחזיר סוג שלא ברשימה פשוט נופל ב-insert.
04 · חילוץ זול: hash, מודל קטן, incremental
פה נשרף רוב הכסף. שלושה כללים.
קודם כל, hash לכל chunk. רק content_hash שעוד לא קיים בטבלה הולך לחילוץ. FalkorDB כותבים את זה ישר: re-index לכל הקורפוס בכל שינוי במסמך “is not viable at scale”.
חוץ מזה, מודל קטן לחילוץ. אתם מבקשים JSON לפי schema סגור, לא שירה. FalkorDB ממליצים על batching, cache ל-entities שחוזרים, ומודלים קטנים ל-pass הראשון. Nickerson הלך רחוק יותר: מודל פתוח של 72B ב-4bit, בערך 40GB, על החומרה שלו, כי אחרת זה לא היה סוגר כלכלית.
ובסוף, תספרו כמה inserts נכשלו על ה-check constraints ותכתבו אותם ללוג. זה ה-eval הכי זול שתקבלו על איכות החילוץ. אם אחוז ה-rejections מטפס, ה-prompt של החילוץ וה-ontology כבר לא מדברים באותה שפה, ועדיף לגלות את זה לפני שהגרף מתמלא בזבל.
05 · שאילתה אחת, לא שרשרת קריאות
ב-Memgraph קוראים לזה Atomic GraphRAG: כל ה-retrieval צריך להיות שאילתה אחת לדאטהבייס, לא שרשרת צעדים באפליקציה. אני מסכים איתם, גם בלי graph DB. כל round-trip בין Python ל-DB הוא עוד latency ועוד מקום לבאג. ה-vector נותן נקודת כניסה, ה-edges נותנים את הקפיצות:
with seeds as ( select id from entities order by embedding <=> $1::vector limit 5),hop1 as ( select e.dst as id, e.chunk_id from edges e join seeds s on e.src = s.id where e.valid_to is null),hop2 as ( select e.dst as id, e.chunk_id from edges e join hop1 h on e.src = h.id where e.valid_to is null)select c.id, c.doc_id, c.bodyfrom chunks cwhere c.id in (select chunk_id from hop1 union select chunk_id from hop2)limit 20;מה שתראו: עד 20 chunks, וכל אחד מהם הגיע דרך edge ספציפי. זה ה-explainability ש-Memgraph מדברים עליו. אפשר להראות למשתמש למה chunk מסוים נכנס ל-context. Iusztin מוסיף שלב hybrid: לאחד את התוצאות של vector, טקסט וגרף עם Reciprocal Rank Fusion. זה כמה שורות, ושווה את זה.
06 · מודדים מול vector RAG רגיל, ומוכנים לזרוק
מריצים את 20 השאלות משלב 01 פעמיים: vector בלבד, ו-vector עם גרף. לכל גרסה שלושה מספרים: recall@10 מול ה-expected_docs, p50 latency, ועלות חילוץ ל-1,000 מסמכים. רק כדי לקבל תחושה של latency: Polygres מדווחים 91% recall@10 ב-2.44ms p50 על GloVe עם 1.18M וקטורים. זה benchmark של vector בלבד, לא של GraphRAG, אבל הוא מראה כמה מעט מה-budget ה-retrieval אמור לאכול.
ההחלטה פשוטה. הגרף צריך לנצח בשאלות ה-multi-hop ולא להפסיד ב-single-hop. אם לא, זורקים אותו ומשאירים כמה JOINs.
מתי כן לעבור ל-graph DB אמיתי, Memgraph או FalkorDB או Neo4j? כשיש מסלולים באורך משתנה, יותר משלוש קפיצות, או שאלות גלובליות על כל הקורפוס. שם recursive CTE ב-Postgres מתחיל לכאוב.
הדעה שלי: community detection וסיכומי קהילות, החלק הכי מפורסם ב-GraphRAG של מיקרוסופט, הוא גם החלק הכי יקר והכי פחות נחוץ ברוב המערכות הארגוניות. המשתמשים שלכם לא שואלים “מה הנושאים המרכזיים בכל הקורפוס”. הם שואלים מי אחראי על השירות שנפל.
מה לקחת
- כותבים 20 שאלות עם ה-paths שלהן לפני שבוחרים טכנולוגיה.
- ה-ontology חי בדאטהבייס כ-check constraints, לא רק ב-prompt.
- מחלצים רק content_hash חדש, במודל קטן, וסופרים rejections.
- כל ה-retrieval בשאילתה אחת. מה שלא ניצח את ה-baseline על השאלות שלכם, יוצא.
מקורות
- Show HN: Instant GraphRAG over any Postgres database · 2026-07-07
- GraphRAG is overkill. This is what we do instead for knowledge graphs · 2026-07-20
- Atomic GraphRAG Explained: The Case for a Single-Query Pipeline · 2026-02-27
- GraphRAG, 27,000 Aviation Accidents, and What OpenClaw Found · 2026-02-21
- Graph Database AI Agents: GraphRAG & Memory Guide
- Building Agentic GraphRAG: Unified Memory With MCP
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 6 מקורות, ונערך ואושר על ידי קובי אלמוג.