Harness engineering: כל מה שמסביב למודל
מה זה harness engineering, מי טבע את המונח, איך עושים את זה בפועל, ולמה agent עם harness טוב מנצח מודל טוב יותר עם harness גרוע.
מאיפה זה הגיע
ב-Anthropic השתמשו במילה harness כבר בנובמבר 2025. בפוסט “Effective harnesses for long-running agents” הם קראו ל-Claude Agent SDK “agent harness כללי”. הם גם הראו איך גרמו ל-Opus 4.5 להתקדם על פני כמה context windows. יש initializer agent שמכין את הסביבה בהרצה הראשונה, ויש coding agent שמתקדם פיצ’ר אחד בכל session ומשאיר artifacts לסשן הבא. הבעיה שהם פתרו: כל session מתחיל בלי זיכרון, כמו משמרת מהנדסים שלא יודעים מה עשתה המשמרת הקודמת.
את הצירוף harness engineering כשם של תחום, Addy Osmani מייחס ל-Viv Trivedy. Trivedy פרסם ב-X את “Anatomy of an Agent Harness” עם הנוסחה “Agent = Model + Harness. If you’re not the model, you’re the harness.” במקביל כתבה על זה Birgitta Böckeler ב-martinfowler.com, ויש מי שמייחסים לה את המונח עצמו. המסמך של Habitat-Thinking, למשל, קושר את המונח ישירות ל-test harness הקלאסי: טסטים לא הופכים קוד לנכון, הם מזהים מתי הוא הפסיק להיות נכון.
מי שהפכה את זה למילה שכולם משתמשים בה היא OpenAI, עם הפוסט “Harness engineering: Leveraging Codex in an agent-first world”. הם בנו מוצר פנימי בלי אף שורת קוד שנכתבה ביד. בחמישה חודשים נכתבו בערך מיליון שורות ונמזגו כ-1,500 PRs, עם שלושה מהנדסים בהתחלה וממוצע של 3.5 PRs למהנדס ביום. המשפט המרכזי שלהם: “Humans steer. Agents execute.” משם זה רק התרחב. במרץ 2026 פרסמה Anthropic ארכיטקטורה של planner, generator ו-evaluator. ביולי כתבה Lilian Weng על ה-harness כשכבה מרכזית ב-recursive self-improvement. והחודש סקרו ב-Marmelab את התחום דרך 246 repos ו-57 פרסומים.
מה זה באמת
Harness engineering זה התכנון של כל מה שעוטף את המודל בתוך agent. ה-prompt וה-AGENTS.md, הכלים, מדיניות ה-context, hooks, sandbox והרשאות, subagents, לולאות בדיקה ומסלולי התאוששות כשמשהו נופל. ההגדרה המסודרת ביותר היא של Lilian Weng: המערכת שמסביב למודל הבסיס, שקובעת איך הוא מתכנן, קורא לכלים, רואה ומנהל context, שומר artifacts ומעריך תוצאות. הגרסה המעשית היא של Osmani: בכל פעם שה-agent טועה, בונים משהו שמונע ממנו לטעות ככה שוב.
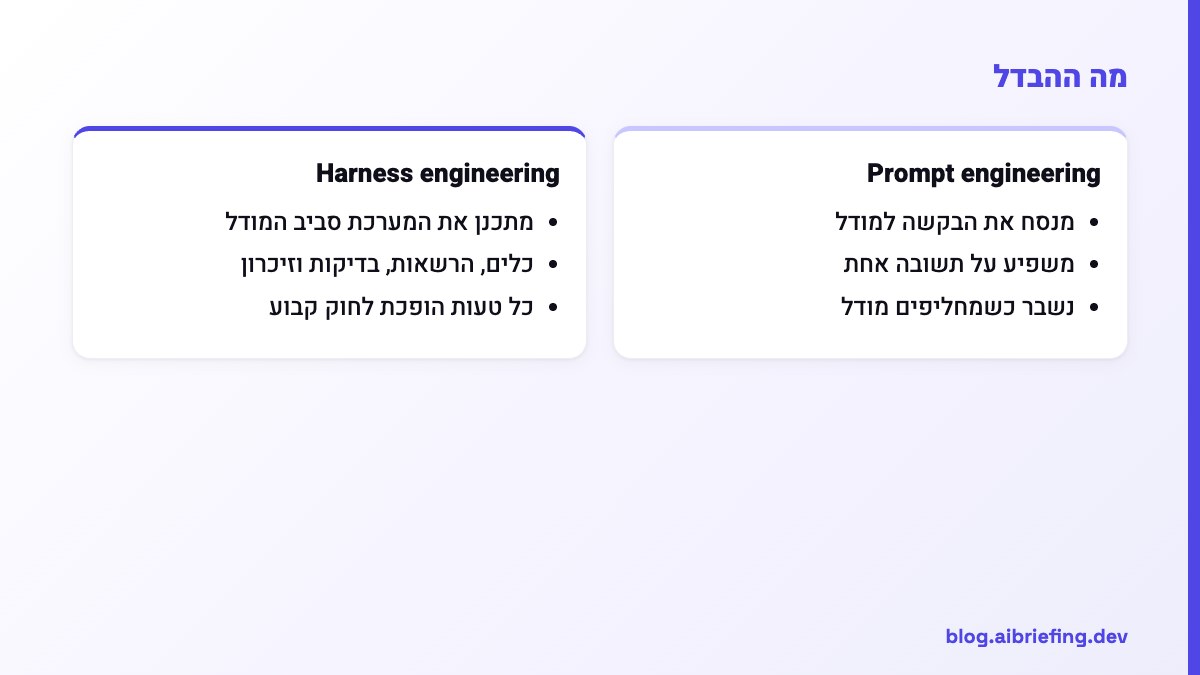
מה זה לא. זה לא prompt engineering, כי ה-prompt הוא רכיב אחד מתוך עשרה. זה גם לא context engineering, שעוסק במה המודל רואה. ה-harness כולל את זה, ומוסיף את מה שהמודל יכול לגעת בו, איך בודקים אותו ומתי מאפסים אותו. וזה לא framework. Agent SDK או LangChain הם חומרי בניין. ה-harness הוא מה שאתם מרכיבים מהם בשביל ה-repo והצוות שלכם.
איך עושים את זה
- מפה, לא אנציקלופדיה. AGENTS.md או CLAUDE.md קצר שמפנה למסמכים. מסמך של 2,000 שורות ה-agent פשוט לא יקרא עד הסוף.
- פירוק ו-artifacts בין sessions. רשימת פיצ’רים ב-JSON, קובץ progress ו-commit אחרי כל צעד. זה מה שמנע מה-agent של Anthropic לנסות לבנות את כל האפליקציה בבת אחת ולהיתקע באמצע בלי context.
- בדיקה דטרמיניסטית אחרי כל פעולה. טסטים, lint, schema ו-type-check שרצים דרך hooks. לא “בבקשה תריץ טסטים” בתוך ה-prompt.
- evaluator נפרד מה-agent שכותב. Anthropic הפרידו generator מ-evaluator בהשראת GANs, כי agent שבודק את עצמו נוטה להכריז על ניצחון מוקדם מדי.
- כל טעות הופכת לחוק. ה-agent שבר convention? עכשיו יש lint rule או בדיקה ב-CI, לא הערה בצ’אט.
- הרשאות ו-sandbox. מחליטים מראש מה ה-agent רשאי למחוק, לדחוף ולעשות לו deploy.
- Observability. לוגים שגם ה-agent וגם בן אדם יכולים לקרוא. בלי זה אתם מדבגים ניחושים.
הדוגמה הכי קצרה לסעיף 3, ב-Claude Code: hook שמריץ טסטים אחרי כל עריכה, ו-exit 2 מחזיר את הכישלון ל-agent.
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [{ "type": "command", "command": "npm test --silent || exit 2" }]
      }
    ]
  }
}
מה זה נותן, ומה זה לא
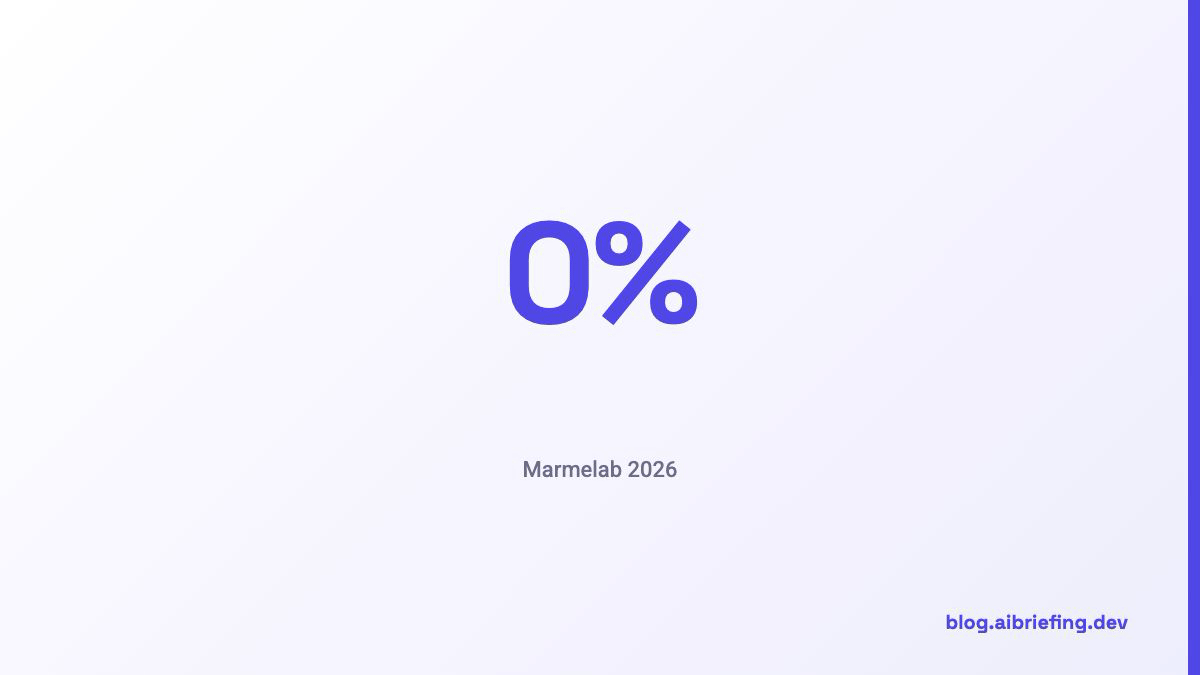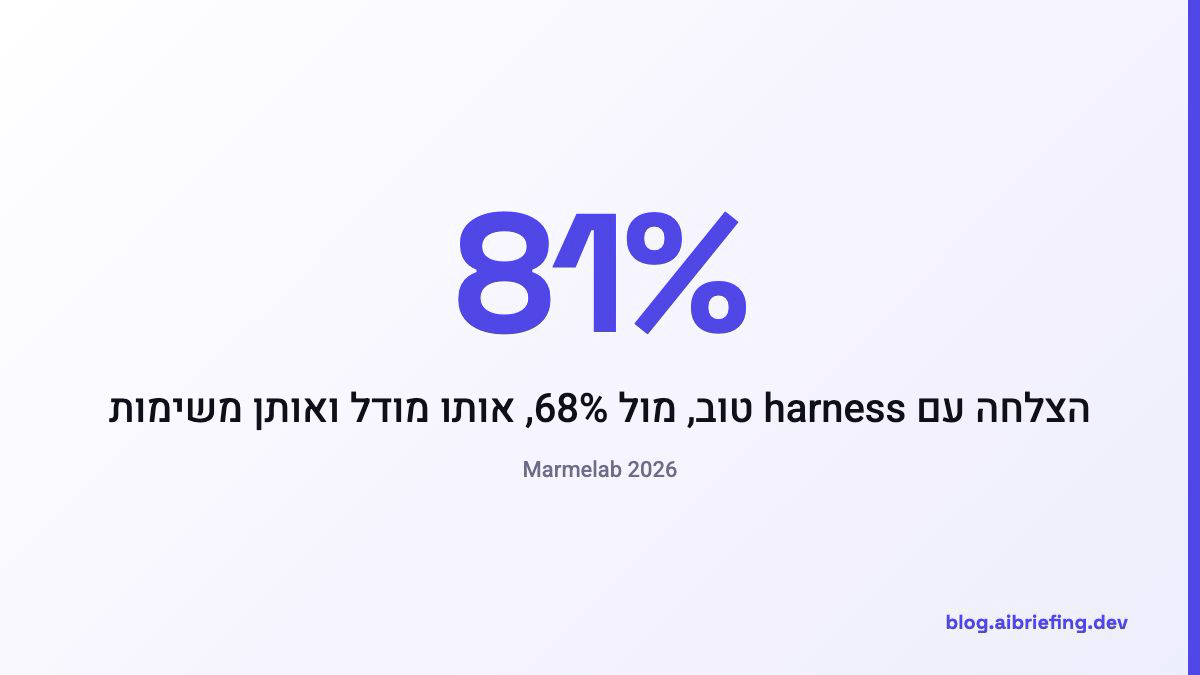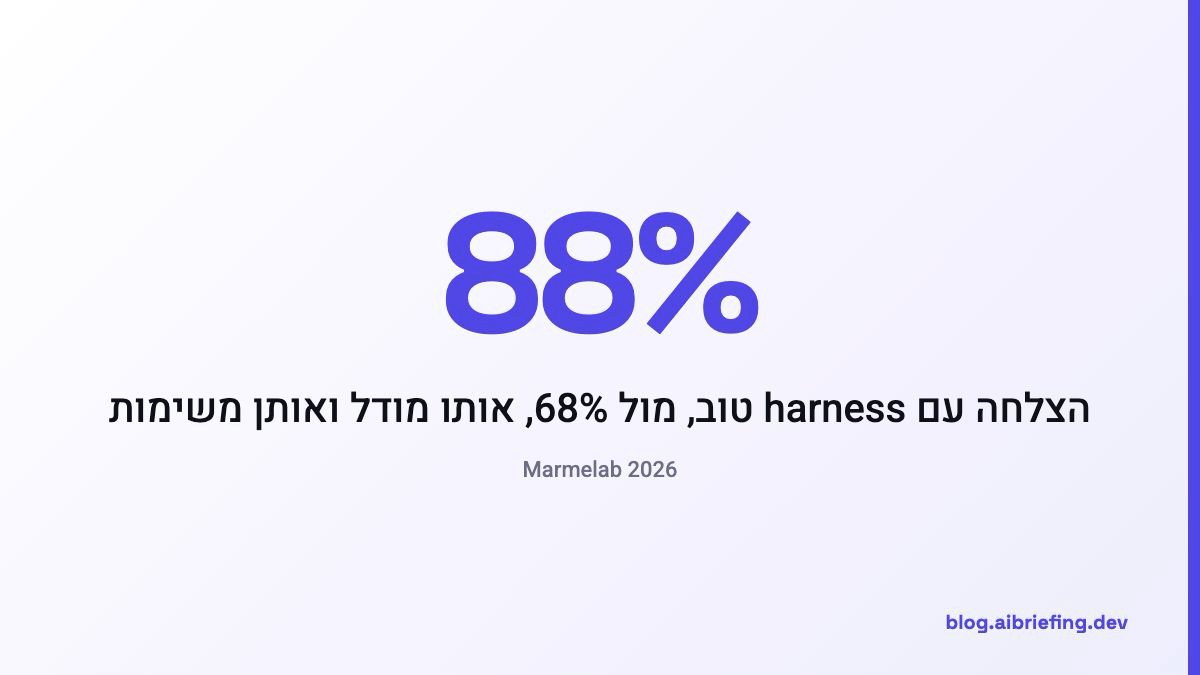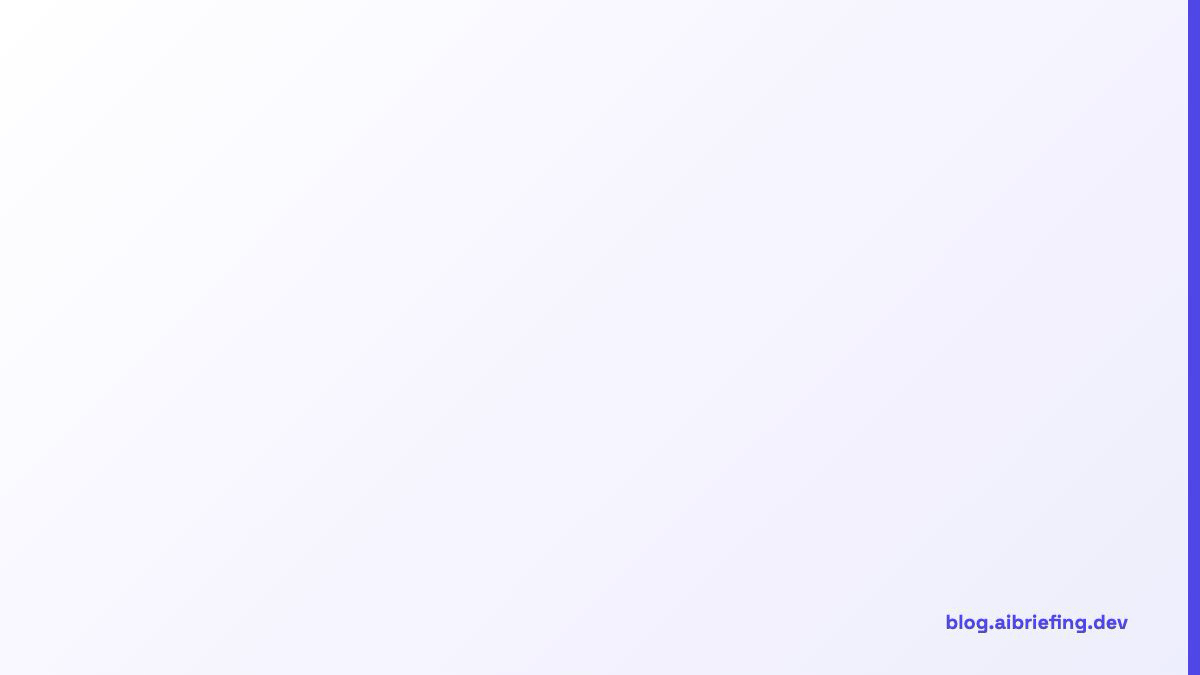
יש מספר אחד שנמדד באמת. מישהו הריץ את אותו מודל דרך 8 harnesses שונים על אותן 25 משימות, עם אותו ספק ואותם כלים. שיעור ההצלחה נע בין 68% ל-88%. ב-Marmelab, שציטטו את הניסוי, מודים שזה בערך הדבר היחיד שמישהו מדד כמו שצריך. כל השאר, כולל רוב מה שכתוב כאן, זה ניסיון מהשטח ולא ניסוי מבוקר.
מה זה לא נותן. harness לא הופך את המודל לחכם יותר, כמו שמנסחים את זה בקורס של walkinglabs. הוא נותן לו מערכת עבודה עם לולאה סגורה. וזה עולה כסף וזמן. כל חוק שהוספתם הוא קוד שצריך לתחזק. החוקים מצטברים ומתנגשים, ובסוף מקבלים harness שאף אחד לא מבין.
ויש את שאלת build vs buy. Rajit Khanna מ-prismvideos מחק agent שבנה על Vercel AI SDK ועבר ל-Hermes, כי זיכרון, skills ו-automations הגיעו שם מוכנים. ההמלצה שלו: אם מישהו כבר בנה את החלק הגנרי, אל תבנו harness משלכם. תשקיעו בכלים ובידע שרק לכם יש.
דוגמה מהשטח
ב-aibriefing.dev רץ כל בוקר גרף של כעשרה agents עם שלב merger. אחרי ה-publish רץ QA evaluator שמסמן P0. ה-wrapper שלנו סביב claude -p הוא harness קטן לכל דבר. הוא עושה retry לתקלות חולפות ומתקן JSON שבור לפני שמישהו מנסה לפרסר אותו. ככה נסגרו שלוש תקלות בפרודקשן. לא עזר מודל טוב יותר, עזרה לולאה של כמה עשרות שורות. הלקח העיקרי: הבאגים הכי גרועים שלנו לא היו תשובות שגויות. הם היו כשלונות שקטים, run שנגמר “בהצלחה” עם תוצר ריק. בגלל זה ה-wrapper יושב ב-shared/ ולא מועתק לכל agent. כשהלוגיקה הזאת הייתה מפוזרת בכמה עותקים, תיקון באחד מהם השאיר את השאר שבורים.
מקורות
- Harness design for long-running application development
- The State Of AI Harness Engineering 2026
- Effective harnesses for long-running agents
- Harness engineering: Leveraging Codex in an agent-first world · 2026-06-05
- Harness engineering for self-improvement · 2026-08-04
- Learn Harness Engineering · 2026-05-18
- Harness Engineering · 2026-08-27
- Building agents without harness engineering · 2026-06-11
- Agent Harness Engineering · 2026-07-12