Jev: כשה-agent צריך החלטה ולא פסקה
Jev של TypeSafe מחזיר החלטה עם הסתברות במקום טקסט. מה הוא עושה בפועל, כמה הוא עולה, ואיך בונים decision layer כבר השבוע.
רוב הצעדים של ה-agent שלכם הם לא כתיבה. הם בחירה מתוך רשימה סגורה. ואתם משלמים עליהם כאילו ביקשתם חיבור.
תסתכלו על trace אמיתי. לאיזה צוות הולך ה-ticket. איזה tool לקרוא. האם הקלט בטוח. האם להעביר לבן אדם. אף אחד מאלה לא צריך פסקה. ובכל זאת אנחנו שולחים אותם ל-LLM שכותב token אחרי token, מפרסרים את מה שחזר, ומתפלאים שהוא המציא tool שלא קיים.
ב-15 בספטמבר 2026 TypeSafe AI הוציאו את Jev, מודל שמחזיר רק את זה: החלטה עם הסתברות. המחיר הוא $42 למיליארד tokens קלט, והפלט בחינם. בדמו בדף הבית שלהם אותה משימה לוקחת 0.114 שניות ועולה $0.000081, מול 8.566 שניות ו-$0.013880 ב-LLM רגיל. ו-Vercel כתבו ש-Jev תפס ב-AI Gateway מהר יותר מכל מודל אחר שהיה שם אי פעם.
Jev הוא function call שמחזיר הסתברות, לא צ’אטבוט
מי שעומד מאחוריו הוא Diogo Almeida. ב-OpenAI הוא עבד על השיטות שגרמו למודלי שפה למלא הוראות ולנהל שיחה, המחקר שהוביל ל-ChatGPT. אחרי שנתיים ב-stealth הוא קרא למה שבנה “System One Model”, על שם החשיבה המהירה והאינטואיטיבית של כהנמן. שיטת האימון נקראת RLCD, Reinforcement Learning for Calibrated Decisions.
בגדול, החוזה פשוט. אתם שולחים state (מייל, שורת log, ticket, JSON) ורשימת שאלות מוקלדות. יש שלושה סוגים: בחירה מתוך אפשרויות שהגדרתם, ציון על rubric, וכן/לא. כל תשובה חוזרת עם הסתברות מכוילת. אין הסבר ואין פסקה.
מה זה לא:
- זה לא LLM קטן יותר. הוא ויתר על יצירת טקסט לגמרי.
- זה לא JSON mode. ב-structured outputs המודל עדיין מייצר מחרוזת שאתם מפרסרים, והוא יכול לשים בתוך JSON תקין לגמרי שם של tool שלא קיים.
- “לא יכול להזות” לא אומר “תמיד צודק”. ב-Beam ניסחו את זה הכי טוב: Jev יכול לבחור את האפשרות הלא נכונה. הוא לא יכול להחזיר משהו מחוץ לרשימה, משהו שבור או משהו שלא עומד ב-schema.
Almeida כתב את זה ככה בפוסט ההשקה:
While Jev gives up string generation, it’s optimized for structured outputs and can’t hallucinate.
— Diogo Almeida, מייסד TypeSafe, 15.9.2026
מה קורה בפנים: צעד אחד, ואז חלוקה
LLM רגיל הוא autoregressive. הוא מייצר token, מזין אותו בחזרה ומייצר עוד אחד. Jev עונה ב-forward pass אחד.
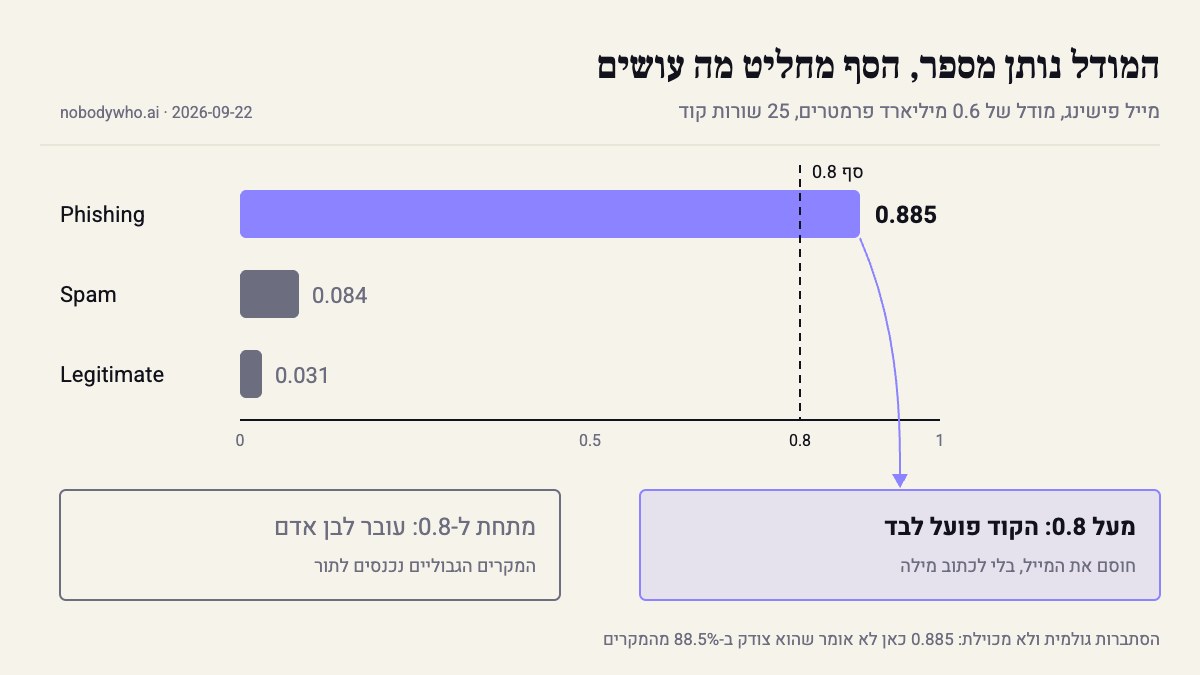
רגע, אז מה קורה שם בפועל? ב-Arcturus Labs מניחים ש-Jev קרוב מאוד ל-LLM רגיל. הוא מריץ צעד אחד, לוקח את התפלגות ההסתברויות על כל ה-tokens האפשריים, ומשאיר רק את אלה שמייצגים את האפשרויות שלכם. ב-nobodywho הלכו עוד צעד ופרסמו ב-22 בספטמבר את “Jev in 25 Lines of Python”: Qwen3-0.6B מקומי, מייל שמבקש סיסמה בדף התחברות שלא של החברה, שלוש אפשרויות. יצא Phishing 0.885, Spam 0.084, Legitimate 0.031. והשורה שלהם: “There. That’s Jev.”
הם צודקים בחצי. המנגנון ישן, ומה ש-TypeSafe מוכרים זה שני דברים שאין ב-25 השורות:
- כיול. softmax גולמי לא אומר כלום על אחוז הפגיעה. לפי ההשוואה של Ollaya, אפילו Ollama מתעדים שההסתברויות של מודלי ההחלטה שהם מריצים לא מכוילות. RLCD אמור לדאוג ש-0.9 באמת יהיה נכון ב-90% מהמקרים.
- מקביליות. עד 256 שאלות בבקשה אחת, ועד 255 אפשרויות לשאלה.
המספרים, על ה-workflows שלהם
$42 למיליארד זה $0.042 למיליון tokens קלט. TypeSafe טוענים שזה מחיר קלט נמוך פי 238 מ-Claude Fable 5.1, ושעל המשימות שלהם Jev מהיר פי 193.6 וזול פי 444.6. המספרים שלהם, על ה-workflows שלהם.
תעשו את החשבון על עצמכם. 100 אלף tickets ביום, 800 tokens כל אחד, זה 80 מיליון tokens. ב-Jev זה $3.36 ליום.
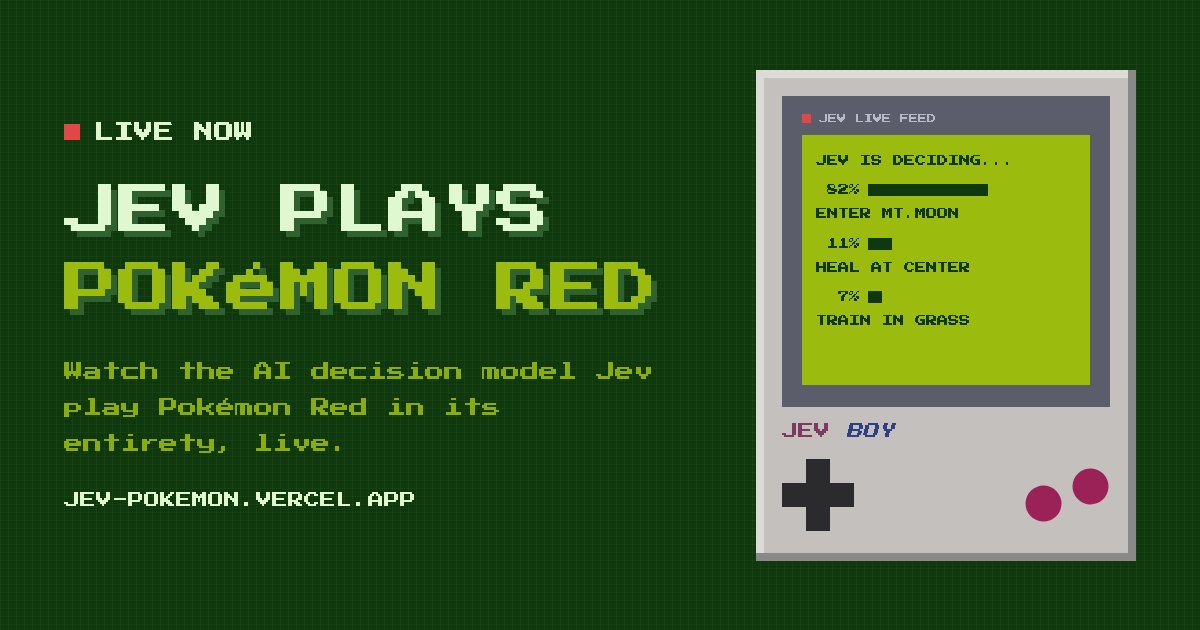
הדוגמה הכי טובה בציבור היא בכלל לא של TypeSafe. Christian Mathiesen מ-Frigade נתן ל-Jev לשחק Pokémon Red עד ה-Hall of Fame: 37 שעות ו-40 דקות, 16,150 החלטות, בערך 39.2 מיליון tokens קלט, וכ-$1.65 בסך הכול. חציון של 0.4 שניות להחלטה. זה בערך סנט לכל מאה החלטות. ועדיין, כל הצוות נפל 16 פעמים, והיו 15 ניסיונות מול ה-Elite Four. המודל לא גאון. הוא פשוט זול מספיק כדי לטעות הרבה.
מה שכן, ב-MindStudio שמו לב שכל הדמואים של ההשקה, Minecraft, רחפן, נהיגה, רצים בתוך סימולטור. על חומרה אמיתית עוד לא ראינו כלום.
איך מכניסים decision layer בלי לחכות ל-early access
הדפוס עצמו לא תלוי ב-Jev. ארבעה צעדים:
- תבודדו ב-agent את הצעדים שהתשובה שלהם סגורה מראש: routing, בחירת tool, safety gate, “להעביר לבן אדם?”.
- תגדירו את האפשרויות בקוד, לא בתוך ה-prompt.
- תקבעו סף. מעליו הקוד פועל לבד, מתחתיו escalate.
- תשמרו את ההסתברות של כל החלטה, כדי שתוכלו למדוד כיול אחר כך.
הנה הגרסה של nobodywho, עטופה בפונקציה עם סף. רצה על לפטופ עם uv run decide.py:
# /// script# requires-python = ">=3.12"# dependencies = ["huggingface-hub", "llama-cpp-python", "numpy"]# ///import numpy as npfrom llama_cpp import Llama
model = Llama.from_pretrained(    repo_id="Qwen/Qwen3-0.6B-GGUF",    filename="Qwen3-0.6B-Q8_0.gguf",    n_ctx=512, logits_all=True, verbose=False,)
def decide(state, choices, threshold=0.8):    labels = [chr(ord("A") + i) for i in range(len(choices))]    options = "\n".join(f"{l}. {c}" for l, c in zip(labels, choices))    prompt = (        "<|im_start|>system\nChoose one option.<|im_end|>\n"        f"<|im_start|>user\n{state}\n\n{options}<|im_end|>\n"        "<|im_start|>assistant\n<think>\n\n</think>\n\n"    )    model.reset()    model.eval(model.tokenize(prompt.encode(), add_bos=False, special=True))    logits = model.scores[model.n_tokens - 1]    ids = [model.tokenize(l.encode(), add_bos=False)[0] for l in labels]    z = np.asarray([logits[i] for i in ids])    p = np.exp(z - np.logaddexp.reduce(z))    best = int(p.argmax())    action = "act" if p[best] >= threshold else "escalate"    return choices[best], round(float(p[best]), 3), action
print(decide(    "Email: Payroll asks for your password on a non-company sign-in page.",    ["Legitimate", "Spam", "Phishing"],))
טוב, ה-0.8 פה הוא ניחוש. על Qwen3-0.6B גולמי, 0.885 לא אומר שהוא צודק ב-88.5% מהמקרים. בגלל זה צעד 4 הוא העיקר.
איפה זה נופל
- הכיול לא מושלם. ב-Arcturus Labs הראו בפוסט מ-16 בספטמבר שההסתברויות של Jev לא תמיד נכונות. גם עם Jev תצטרכו לבדוק על הדאטה שלכם.
- רק מרחב תשובות סגור. צריך תשובה ללקוח, תקציר או קוד? זה עדיין LLM.
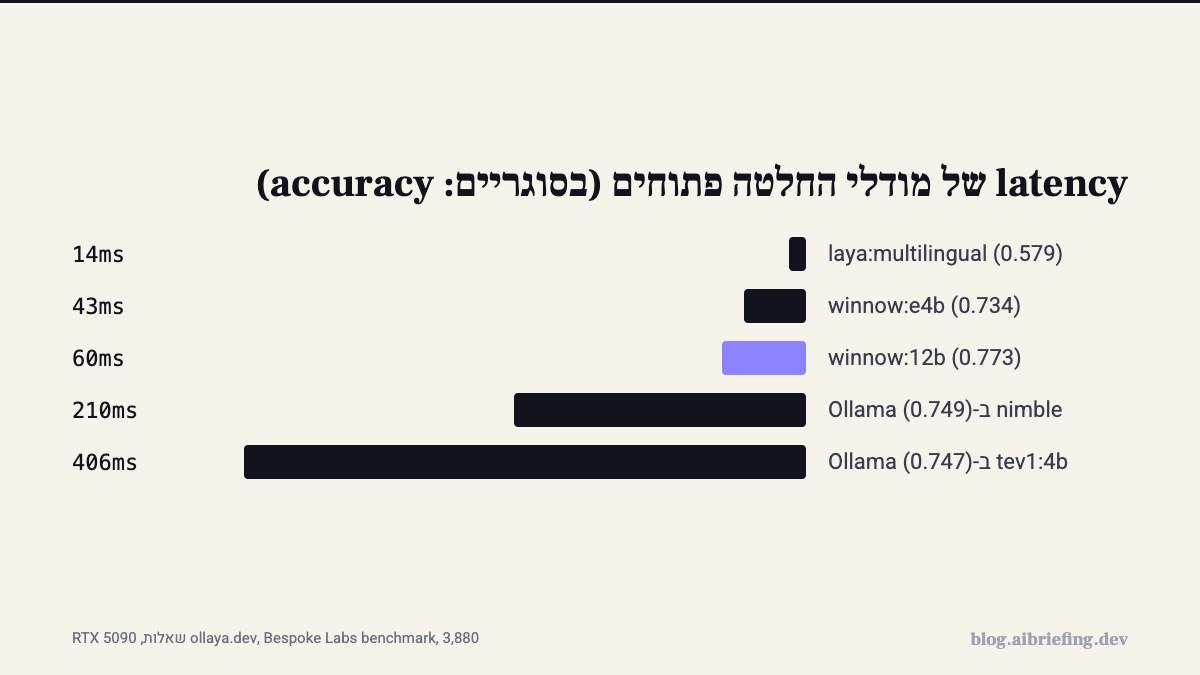
- תלות בספק. early access אצל חברה אחת זה סיכון. ב-25 בספטמבר יצא Ollaya, “Ollama למודלי החלטה”: 15 משפחות של מודלים פתוחים ואותם endpoints כמו של TypeSafe (
/v1/systemone). winnow:e4b קיבל אצלם 0.722 בהחלטות מוקלדות, מול 0.738 של Jev המתארח, ב-89ms על RTX 4090. - החפיר. ב-Arcturus טוענים ש-OpenAI משתמשים כבר שנים ב-LLM שלהם כמסווגים מרומזים, ושהחפיר האמיתי של TypeSafe הוא דאטה האימון. אם OpenAI ישחזרו את האימון, הם יכולים להכניס את היכולת הזו לתוך המודלים וה-agents שלהם, ו-Jev לא יוכל להתחרות בזה.
הדעה שלי: אני לא קונה את ה-238x כמספר שאמור לעניין אתכם. אצל רוב הצוותים החשבונית על routing היא לא הבעיה. הבעיה היא ה-tool שהומצא בשלוש בלילה, ומה שאני לוקח מ-Jev זה הצורה: תשובה שסגורה מראש, עם מספר שאפשר לשים עליו סף.
מה לנסות השבוע
- תפתחו trace של agent ב-production ותספרו כמה צעדים הם בחירה מתוך רשימה. ב-Beam טוענים שזה רוב הצעדים. תבדקו אם זה נכון אצלכם.
- תבחרו צעד אחד, נגיד routing של tickets, ותתייגו ידנית 200 דוגמאות.
- תריצו עליהן את
decide.pyאו מודל מ-Ollaya. תמדדו accuracy, ותחלקו את ההסתברויות לדליים של 0.1. בכל דלי, אחוז הפגיעה צריך להיות קרוב להסתברות. זה ה-ECE ש-Ollaya מפרסמים לכל מודל. - תקבעו את הסף מהדאטה: כמה אחוז נופל ל-escalate, ומה הדיוק מעליו.
- רק אז תבקשו early access ל-Jev ותריצו את אותן 200 דוגמאות.
אם 0.9 אצלכם לא נכון ב-90% מהמקרים, אין לכם decision model. יש לכם softmax יפה.
מקורות
- Home - TypeSafe AI
- Introducing System One Models and Jev · 2026-09-15
- Jev in 25 Lines of Python · 2026-09-23
- Ollaya – Ollama for open-source, Jev-style decision models · 2026-09-25
- OpenAI is well positioned to fast-follow Jev · 2026-09-22
- Show HN: Jev Plays Pokémon Red · 2026-09-25
- Jev by TypeSafe: A Decision Model for AI Agents
- Jev Explained: Typesafe AI's Non-Autoregressive System-1 Model | MindStudio
- What Is Jev AI? A Practical Guide to System One and Executable Decisions
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 9 מקורות, ונערך ואושר על ידי קובי אלמוג.