Long-running agents: איך agent עובד 36 שעות בלי לאבד את החוט
long-running agents בלי הייפ. למה 1M tokens לא מספיק, איך בונים לולאה עם progress file ובדיקה אוטומטית, ו-harness בעמוד אחד להעתיק
36 שעות על משימה אחת
ב-12 בפברואר 2026 קרסר פתחו את ה-long-running agents שלהם לכל משתמשי Ultra, Teams ו-Enterprise. ברשימת הריצות מה-research preview יש אחת שקשה לפספס: agent שבנה פלטפורמת צ’אט חדשה מעל כלי open-source קיים. 36 שעות ריצה. לידה יש אפליקציית מובייל שנבנתה מתוך web app קיים ב-30 שעות, ו-refactor של מערכת auth ו-RBAC ב-25.
רגע, אף מודל לא מחזיק 36 שעות ב-context אחד. מה שקרסר בנו זה harness. לפי הפוסט שלהם, המודלים המובילים נכשלים במשימות ארוכות בדרכים די צפויות: הם שוכחים את התמונה הגדולה, מאבדים את החוט ועוצרים באמצע. אז ה-agent אצלם מציע תוכנית ומחכה לאישור לפני שהוא נוגע בקוד, ובזמן הריצה כמה agents בודקים אחד את העבודה של השני. מה שהם בחרו להבליט: PRs גדולים משמעותית, עם merge rate דומה לזה של agents אחרים.
מה זה long-running agent, ומה זה לא
אף אחד לא המציא את השם, הוא פשוט נדבק במהלך 2026. אדי אוסמני ניסח את ההגדרה הכי שימושית, בפוסט מ-28 באפריל:
A long-running AI agent can keep making progress over hours, days, or weeks. It can do this across many context windows and sandboxes, recover from failure, leave structured artifacts behind, and resume where it left off. — Addy Osmani, “Long-running Agents”
אוסמני מפריד בין שני דברים שכל הזמן מתערבבים. long-horizon reasoning זה סיפור של המודל: כמה צעדים תלויים הוא מחזיק בלי להתברבר. METR מודדים את זה, והמדד שלהם מכפיל את עצמו בערך כל 7 חודשים מאז 2019. long-running execution זה סיפור של ה-harness: התהליך רץ שעות או ימים, והמודל נקרא אלפי פעמים לאורך הריצה. הפוסט הזה על השני, כי אותו אפשר לבנות כבר היום.
מה זה לא: זה לא צ’אט ארוך. וזה גם לא “agent עם context של מיליון tokens”. זאת בדיוק הטעות.
למה מיליון tokens לא פותר את זה
ב-13 במרץ 2026 אנטרופיק הוציאו את ה-1M context ל-GA על אופוס 4.6 וסונט 4.6, בלי תוספת מחיר. בקשה של 900K עולה לכל token כמו בקשה של 9K. נשמע כמו הפתרון.
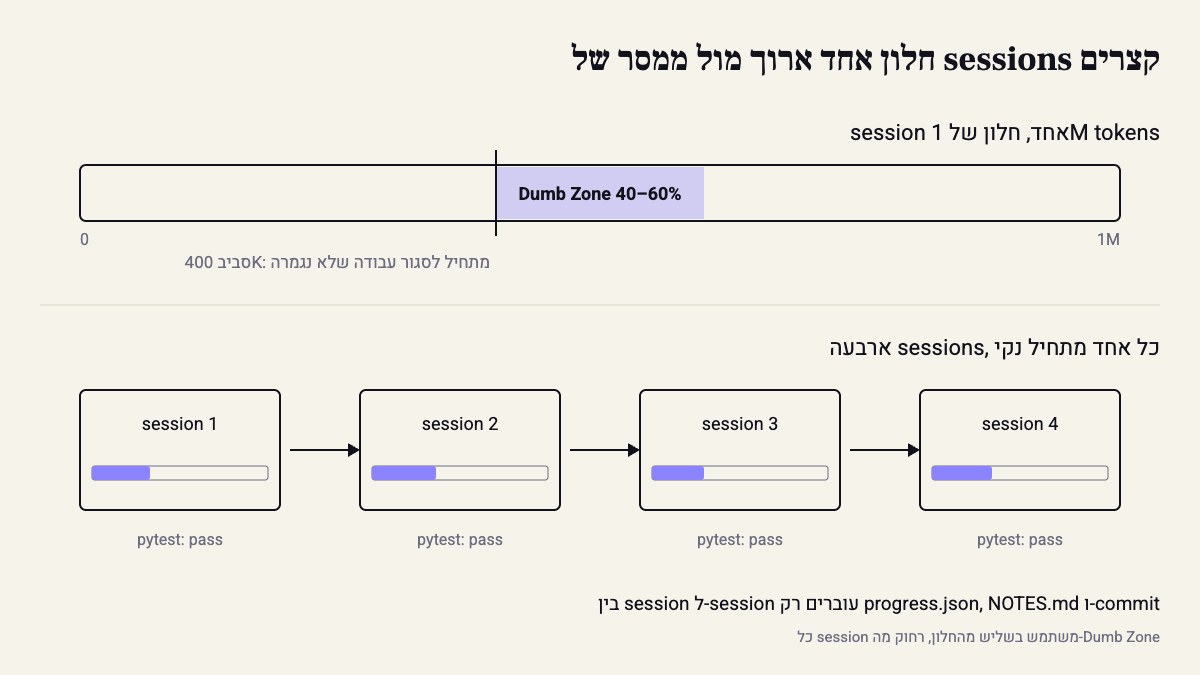
לא ממש. דקס הורת’י מ-HumanLayer ניתח 100,000 sessions של מפתחים וקרא לבעיה Dumb Zone: באזור האמצעי של החלון, בערך 40% עד 60%, ה-recall יורד וה-reasoning מתחיל לזייף. וינוד ת’יאגרג’ן תיאר את זה מהשטח: ה-agent מתחיל חזק, ובסביבות 400K משהו משתנה. התשובות נהיות מעורפלות, והוא מתחיל “לסגור” עבודה שלא נגמרה. אנטרופיק קוראים לזה context anxiety.
ו-compaction לא מציל. סיכום של ההיסטוריה מאבד את הניואנס של החלטות קודמות, והמודל ממציא פרטים שהיו במקור ולא נכנסו לסיכום.
הפתרון שכולם הגיעו אליו, כל אחד מכיוון אחר: לזרוק את ה-context. כל session מתחיל נקי, וההעברה בין sessions עוברת דרך artifacts מובנים: קובץ progress, רשימת משימות, git commits. לא היסטוריה מכווצת.
הלולאה, צעד אחרי צעד
בגדול, זה תמיד אותו מבנה. ה-repo הציבורי של אנטרופיק, cwc-long-running-agents, מפרק אותו ל-planner, generator ו-evaluator, עם default fail criteria ועם evaluation ב-context נקי, כדי שאותו agent לא יעשה את העבודה וגם ישפוט אותה. ה-Agent Framework של מיקרוסופט מגיע לאותו מקום מכיוון ה-workflows: checkpoints, resume, human gates.
- planner הופך את המטרה לרשימת משימות, עם פקודת בדיקה לכל אחת, ושומר אותה בקובץ.
- worker לוקח משימה אחת pending, ב-session חדש, ב-sandbox עם כלים מוגבלים.
- evaluator מריץ את הבדיקה. פקודה (tests, schema) עדיפה על מודל.
- עבר? commit ו-checkpoint. נכשל? rollback, שומרים את השגיאה, והמשימה חוזרת ל-pending.
- אחרי 3 כישלונות המשימה עוברת ל-blocked ובן אדם מסתכל.
- התהליך נפל באמצע? מריצים שוב, והוא ממשיך מה-checkpoint האחרון.
harness בעמוד אחד
זה המינימום שהייתי מריץ לפני שהייתי קונה פלטפורמה. ב-progress.json יש רשימת משימות בפורמט {"id": 3, "goal": "...", "check": "pytest -q tests/test_auth.py", "status": "pending"}, ו-NOTES.md הוא היומן שה-agent עצמו כותב בסוף כל משימה. שני הקבצים ב-git.
import json, pathlib, shlex, subprocess
STATE = pathlib.Path("progress.json")MAX_ATTEMPTS = 3
def sh(cmd: str) -> subprocess.CompletedProcess:    return subprocess.run(cmd, shell=True, capture_output=True, text=True)
state = json.loads(STATE.read_text())
for task in state["tasks"]:    if task["status"] != "pending":        continue    prompt = (        f"Read progress.json and NOTES.md first. Do ONLY task {task['id']}: {task['goal']}. "        f"Previous failure, if any: {task.get('last_error', 'none')}. "        "Before you stop, append to NOTES.md what you changed and what is left."    )    # fresh session every task: no history beyond the files    sh(f"claude -p {shlex.quote(prompt)} --max-turns 40")
    check = sh(task["check"])  # deterministic evaluator: exit code, not a model    if check.returncode == 0:        task["status"] = "done"        STATE.write_text(json.dumps(state, indent=2))        sh(f"git add -A && git commit -qm 'agent: task {task['id']} done'")    else:        sh("git checkout -- . && git clean -fdq")  # never build on a broken attempt        task["attempts"] = task.get("attempts", 0) + 1        task["last_error"] = (check.stdout + check.stderr)[-1500:]        task["status"] = "blocked" if task["attempts"] >= MAX_ATTEMPTS else "pending"        STATE.write_text(json.dumps(state, indent=2))        break  # next run starts from a clean tree, with the error in hand
מריצים בלולאה, למשל for i in $(seq 20); do python harness.py; done, ב-container או ב-worktree נפרד. שלושה דברים פה עושים את כל העבודה. קודם כל, כל קריאה ל-claude -p היא session חדש, ואין שום היסטוריה חוץ משני הקבצים. חוץ מזה, ה-evaluator הוא exit code ולא מודל. ואחרי כישלון יש rollback, אז הניסיון הבא מתחיל על קוד נקי, רק עם השגיאה ביד.
הדעה שלי: ה-evaluator הוא העיקר פה, לא ה-agent. agent ארוך בלי בדיקה דטרמיניסטית הוא פשוט דרך יקרה לייצר הרבה קוד שאף אחד לא בדק. אם אין לכם פקודה שאומרת עבר או לא עבר, המשימה לא מוכנה לרוץ לבד בלילה.
מי מריץ את זה, ומתי לא
את קרסר כבר ראינו: תוכנית מאושרת מראש ו-agents שבודקים זה את זה. Superserve, שעלו ב-Show HN ביולי, פתרו את צד התשתית: Firecracker microVMs בלי מגבלת 24 שעות, pause בלי הגבלת זמן כדי לא לשלם על idle, snapshot ו-fork, ו-credentials broker שיושב בין ה-agent ל-APIs, כך שלמודל אין מפתחות ביד. החיוב לפי שנייה.
אנבידיה הלכו על המודל. Nemotron 3 Ultra, שיצא ב-4 ביוני, הוא MoE של 550B עם 55B פעילים, ו-95% ב-Ruler על 1M. אבל הרעיון המעניין בפוסט שלהם הוא system of models: מודל מוביל לתכנון ולקריאות הקשות, ומודל זול לביצוע, בדיקה ו-tool calls. רוב הקריאות בריצה ארוכה הן שגרתיות, ואין סיבה לשלם עליהן מחיר של אופוס.
ומתי לא? אם אין בדיקה אוטומטית למשימה. אם המשימה לוקחת פחות משעה, agent רגיל מספיק. ואם ה-agent צריך credentials של production כדי להתקדם. ריצה של 30 שעות זה המון קריאות, וכל אחת מהן היא הזדמנות לטעות עם הרשאות אמיתיות.
מה לנסות השבוע
- תבחרו משימה אחת מה-backlog שיש לה כבר test suite, ותפרקו אותה ידנית ל-3 עד 5 משימות ב-progress.json. לכל אחת שדה
checkעם פקודה אמיתית. - תריצו את ה-harness למעלה בלילה, ב-container או ב-git worktree, בלי שום credential של production.
- תמדדו בבוקר שלושה מספרים: כמה משימות עברו בניסיון הראשון, כמה ניסיונות בממוצע, וכמה עלתה כל משימה.
- אם יותר משליש מהמשימות נגמרו ב-blocked, הבעיה כנראה בחלוקה למשימות ולא במודל. תקטינו אותן.
- תשאירו
--max-turnsו-MAX_ATTEMPTSקשיחים. agent בלי תקרה ימשיך לשרוף tokens על אותה שגיאה עד הבוקר.
agent שרץ 36 שעות בלי בדיקה הוא לא long-running. הוא פשוט long.
מקורות
- Show HN: Superserve – Firecracker microVM sandboxes for long-running AI agents · 2026-07-21
- Long-Running Agents · 2026-04-30
- Nvidia released Nemotron 3 Ultra, a new open model · 2026-06-04
- Curosr: Expanding our long-running agents research preview · 2026-02-14
- Own the Loop — An Agent-Agnostic Guide to Long-Running Agents
- AddyOsmani.com - Long-running Agents
- Build a Long Running AI Agent + Full Code
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 7 מקורות, ונערך ואושר על ידי קובי אלמוג.