38% בלי אינטרנט: מה נשבר כשמריצים coding agent על מודל מקומי
Antigma הריצו 8 מודלים פתוחים על 89 משימות Terminal-Bench, בלי רשת. ה-27B הגיע ל-38%, ה-4B נפל על tool calls. הנה מה לבדוק אצלכם.
- 01מדדו invalid tool calls על 50 קריאות לפני שבוחרים מודל מקומי.
- 02הריצו llama-server עם --jinja ותבדקו שה-tool calls חוזרים כ-JSON תקין.
- 03תצפו לרמה של המודלים המובילים לפני 6–8 חודשים, לא של היום.
38 אחוז על 89 משימות
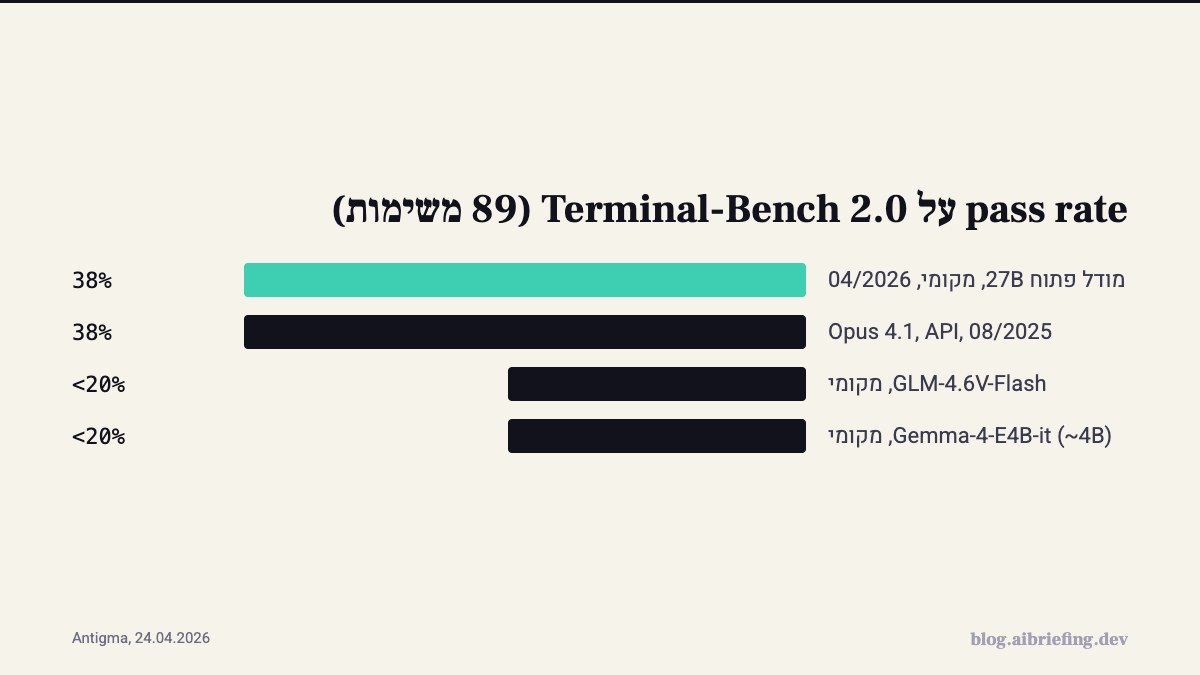
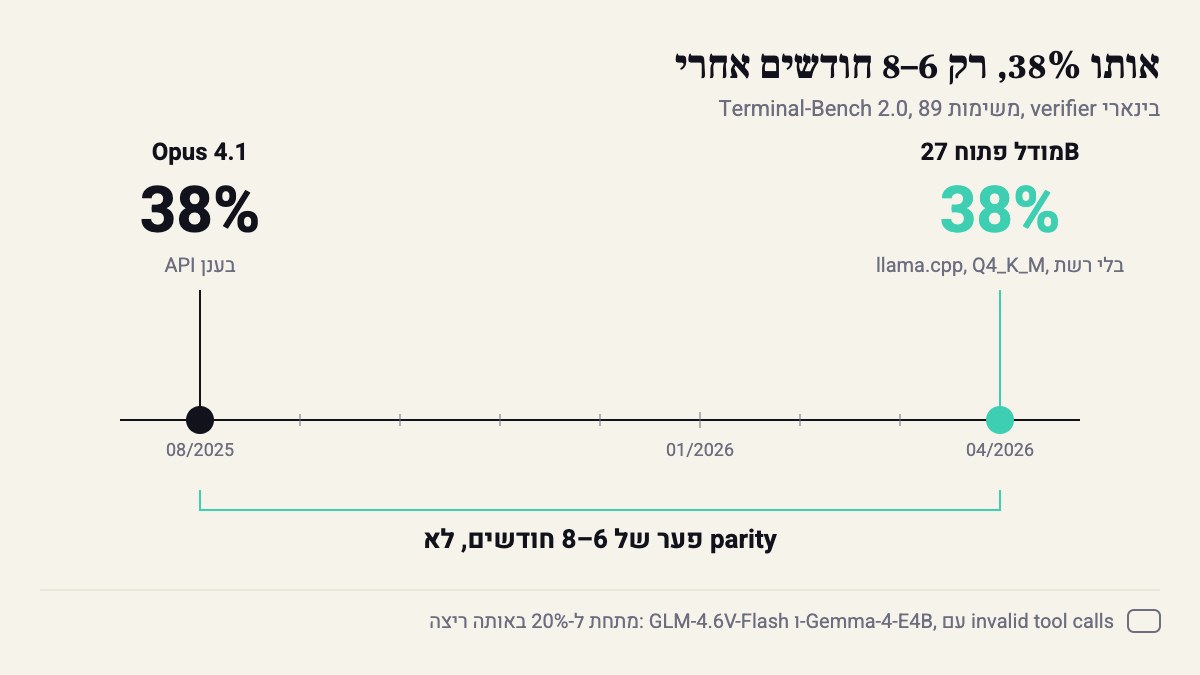
38%. זה ה-pass rate שמודל פתוח בגודל 27B הוציא על Terminal-Bench 2.0, כשהוא רץ מקומית על תחנת עבודה אחת. Opus 4.1 של אנטרופיק הוציא את אותו מספר באוגוסט 2025. בגדול, קוד שאסור לו לצאת מהרשת קיבל באפריל 2026 את מה שהמודלים המובילים נתנו בענן 6–8 חודשים קודם.
הסיפור הוא של Antigma, חברה שבונה coding agent בשם Ante. הם פרסמו אותו ב-24 באפריל 2026, וה-setup מתועד עד רמת הקומיט: terminal-bench-2.git @ 69671fb, 89 משימות, אותו harness בכל הריצות. משימה נחשבת עוברת רק אם ה-verifier מחזיר reward == 1.0. אז 38% זה בערך 34 משימות מתוך 89.
הם בדקו שמונה מודלים: Qwen 3.6-27B, Qwen 3.5-27B, Qwen 3.5-35B, Gemma-4-31B, Gemma-4-26B-A4B, GLM-4.6V-Flash, Qwen 3.5-9B ו-Gemma-4-E4B-it. כל קבצי ה-GGUF הגיעו מ-unsloth ב-Hugging Face, ב-quantization של Q4_K_M או UD-Q4_K_M, וה-inference רץ על llama.cpp. בלי cloud ובלי API key.
הריצה שנפלה: 4B שלא יודע לקרוא לכלי
שני מודלים לא נכנסו בכלל לטבלה הראשית. GLM-4.6V-Flash ו-Gemma-4-E4B-it נשארו שניהם מתחת ל-20%. ועל ה-4B הם כותבים שהריצה הייתה לא יציבה, עם “frequent invalid tool calls”.
רגע, למה זה הפרט הכי חשוב בכל הפוסט? כי זה לא כישלון מסוג “המודל לא מספיק חכם לפתור את הבאג”. זה כישלון של חוזה. ה-agent מצפה ל-JSON בפורמט מסוים כדי להריץ פקודה בטרמינל, והמודל מחזיר משהו שה-harness לא יכול לבצע. במשימה של 30 צעדים כל צעד הוא הימור על הפורמט, והמשימה נופלת הרבה לפני שהמודל מגיע ללוגיקה.
ככה נראה offline coding כשהוא נשבר. לא תשובה גרועה, אלא לולאה שנתקעת.
איך זה נראה מבחוץ: כמו Opus
הכותרת שהסתובבה הייתה “Open-weight 27B hits 38% on Terminal-Bench 2.0”, ומי שקורא רק אותה מבין שיש parity. Antigma עצמם זהירים יותר:
And for teams that cannot send code and data to external APIs — regulated environments, air-gapped deployments, customer-data-sensitive workflows, or offline laptops — the gap is finally small enough that “run it locally” is a serious engineering option rather than a thought experiment. — Antigma, אפריל 2026
כמה שורות קודם הם כותבים במפורש שהמודלים האלה “not at parity with today’s best hosted models”. הם משווים את זה למעבר מהארקייד ל-SNES: Street Fighter II בבית היה פחות חלק, ואנשים שיחקו בו שעות כי הוא תמיד היה זמין. הדימוי קולע. ה-38% זה לא קלוד של היום. זה בערך מה שהיה בענן לפני חצי שנה ומשהו, רק שעכשיו הוא רץ אצלכם על ה-GPU.
התיקון הראשון שכולם עושים
צוות מקבל דרישת air-gap, מוריד מודל, מחבר ל-IDE, והתוצאות מאכזבות. התגובה הראשונה כמעט תמיד: להחליף מודל. גדול יותר אם יש GPU, קטן יותר אם המכונה נחנקת. ובמקביל לנסות שוב ושוב עם עוד תיקונים בתוך ה-prompt.
ל-ElixirData, שבנו agent שרץ כולו בתוך רשת מנותקת, יש לזה שם: ה-Frustration Loop. מייצרים קוד, בודקים, מגלים שהוא לא מתאים ל-codebase, מייצרים שוב עם תיקונים, בודקים שוב, ובסוף או מקבלים פלט שעבר שכתוב כבד או זונחים. בענן אפשר להסתיר את זה עם מודל חזק יותר. offline אין לאן לברוח.
הסיבה האמיתית: מה המודל רואה ומה מותר לו לעשות
ElixirData כותבים שהאילוץ דווקא עשה להם סדר. מה שקובע את איכות הקוד זה פחות המודל ויותר ה-context שמגיע אליו והתוכנית שהוא עובד לפיה. המספר שלהם: פי 120 פחות טוקנים כשעוברים מ-grep קובץ-אחרי-קובץ לאינדקס מובנה של ה-codebase. במודל מקומי, עם context window מוגבל וכל טוקן שעולה זמן על GPU אחד, זה לא אופטימיזציה. זה ההבדל בין משימה שנגמרת למשימה שלא.
הם מפרקים את העבודה לשלושה מודלים, Planner, Generator ו-Completer, ובאמצע יושב Plan.MD: מסמך שאדם קורא ומאשר לפני ששורת קוד אחת נכתבת. לפי ElixirData, זה ה-artifact שהכי משפיע על התוצאה במערכת.
עכשיו תחזרו לריצה של Antigma, והתמונה מתחברת. ה-harness היה קבוע, ה-suite היה קבוע, וההבדל בין 38% לפחות מ-20% עבר דרך היכולת של המודל לעמוד בחוזה של ה-harness. מודל שלא מוציא tool call תקין לא מגיע לשלב שבו context טוב יכול לעזור לו.
הדעה שלי: הייתי מתחיל מה-harness ולא מהמודל. Qwen החליף גרסה בין שתי שורות באותה טבלה, ואת המודל תחליפו שוב בעוד חודשיים. הבדיקות שכתבתם על החוזה נשארות.
מה לבדוק אצלכם לפני שבוחרים מודל
קודם כל, להרים את המודל כמו ש-Antigma הרימו: llama.cpp, קובץ GGUF ב-Q4_K_M, ו---jinja כדי שה-chat template של המודל יטפל ב-tool calling:
llama-server -m ./models/model-Q4_K_M.gguf --jinja -c 32768 -ngl 99 --port 8080חוץ מזה, לפני שמריצים benchmark שלם, מודדים את החוזה. הסקריפט הזה שולח 50 בקשות עם כלי אחד ל-endpoint התואם-OpenAI של llama-server, וסופר כמה פעמים חזר משהו שה-harness שלכם לא היה מצליח לבצע:
import json, sys, urllib.request
URL = "http://localhost:8080/v1/chat/completions"TOOLS = [{    "type": "function",    "function": {        "name": "run_shell",        "description": "Run a shell command in the repo",        "parameters": {            "type": "object",            "properties": {"cmd": {"type": "string"}},            "required": ["cmd"],        },    },}]PROMPT = "List the Python files in the current directory, then count their lines."N = int(sys.argv[1]) if len(sys.argv) > 1 else 50
bad = 0for i in range(N):    body = json.dumps({        "messages": [{"role": "user", "content": PROMPT}],        "tools": TOOLS,        "temperature": 0.7,    }).encode()    req = urllib.request.Request(URL, body, {"Content-Type": "application/json"})    msg = json.load(urllib.request.urlopen(req, timeout=300))["choices"][0]["message"]    try:        call = msg["tool_calls"][0]["function"]        assert call["name"] == "run_shell"        args = json.loads(call["arguments"])        assert isinstance(args.get("cmd"), str) and args["cmd"].strip()    except (KeyError, IndexError, TypeError, ValueError, AssertionError):        bad += 1        print(f"#{i}: invalid -> {str(msg)[:120]}")
print(f"invalid tool calls: {bad}/{N} ({bad / N:.0%})")sys.exit(1 if bad else 0)
בפועל, מה שהייתי מוודא השבוע:
- 0 invalid מתוך 50. נשמע קשוח, אבל במשימה של 30 צעדים גם 3% שגיאות פורמט נותנות סיכוי לא קטן שמשהו נשבר באמצע. מודל שלא עומד בזה לא נכנס לרשימה.
- אותו harness לכל מודל. כמו Antigma: מחליפים רק את קובץ ה-GGUF, אחרת אתם משווים setup ולא מודלים.
- עשר עד עשרים משימות מ-Terminal-Bench 2.0 על החומרה שלכם, לפני שמתחייבים. ה-38% הם על ה-GPU של מישהו אחר.
- הרשת באמת סגורה. תריצו את כל ה-stack בקונטיינר עם
--network none. אם משהו מנסה להוריד tokenizer או template מ-Hugging Face בזמן ריצה, עדיף לגלות את זה עכשיו ולא בתוך ה-air-gap. - Plan.MD לפני קוד במשימות של יותר מקובץ אחד. אדם מאשר תוכנית בדקה, ומודל מקומי חוסך עשר הרצות של Frustration Loop.
בקיצור: מודל שלא מחזיק 50 קריאות לכלי בלי שגיאה לא יחזיק 89 משימות, ולא משנה כמה פרמטרים כתובים לו בשם.
מקורות
- Open-weight 27B hits 38% on Terminal-Bench 2.0 (Opus 4.1 hit 38% in Aug 2025) · 2026-04-28
- From Copilot to agents: The history of AI coding
- Building an Offline AI Coding Agent: Three-Model Architecture, Context OS, and the Plan.MD Pipeline
- Coding Agents: What They Are and How They Work | Snowflake
- What are AI Agents?- Agents in Artificial Intelligence Explained - AWS
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.