Same engineering: אותן משימות, ציון אחר, ואף מודל לא השתנה
ב-DeepSWE v1.1 שינו רק את ה-execution וה-grading, ומשימות זזו ב-36 נקודות. איך מודדים את זה אצלכם בלי לבלבל רעש עם שיפור
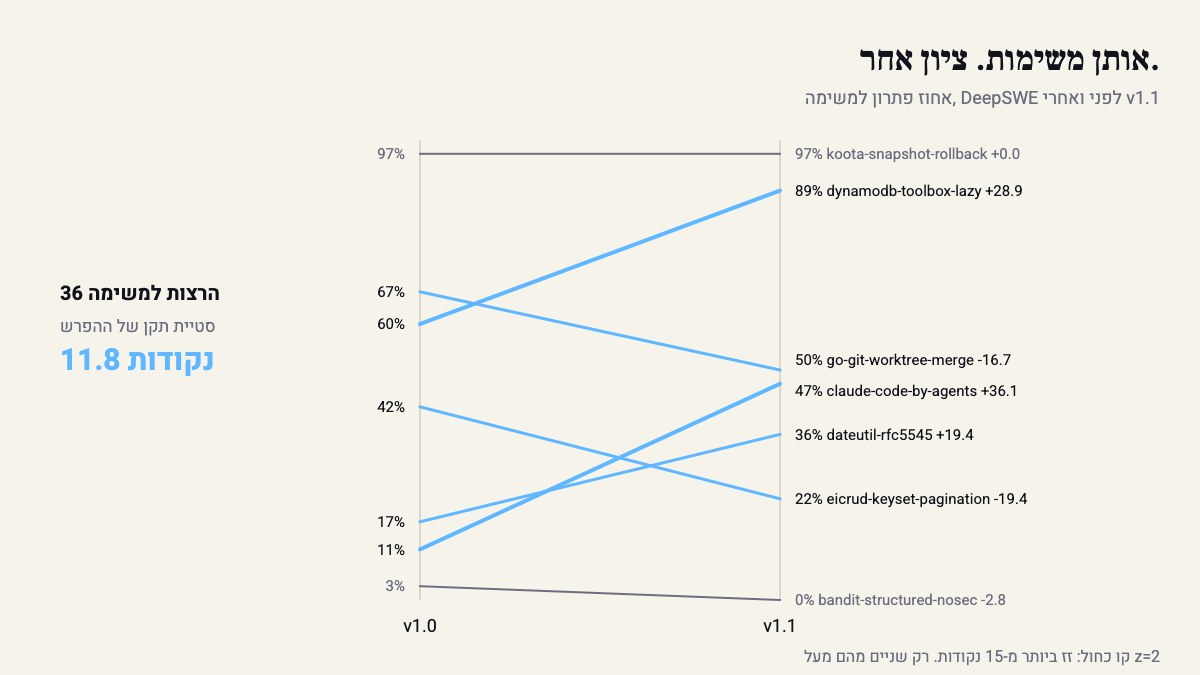
יש שורה אחת בטבלה של DeepSWE v1.1 שכדאי לקרוא פעמיים. המשימה היא claude-code-by-agents-recursive-delegation. בגרסה הקודמת של ה-benchmark היא נפתרה ב-11% מההרצות, ובגרסה החדשה ב-47%. קפיצה של 36.1 נקודות.
אף מודל לא השתנה בשביל זה. Datacurve, שמחזיקים את DeepSWE, אמרו את זה כבר בכותרת: “Updated execution and grading for the same engineering tasks”. אותן משימות. מה שהשתנה זה איך מריצים אותן ואיך בודקים אם הן נפתרו.
ובאותה טבלה, באותו עדכון: eicrud-keyset-pagination-cursor ירדה מ-42% ל-22%, ו-go-git-worktree-merge-conflicts ירדה מ-67% ל-50%. koota-entity-snapshot-rollback נשארה בדיוק על 97%.
same engineering זה לא מונח. זה ניסוי
טוב, צריך להגיד את זה מההתחלה: אף אחד לא טבע את “same engineering”. זה חצי משפט מכותרת של בלוג, והוא נדבק כי הוא מתאר משהו שאין לו שם טוב. הניסוי שמאחוריו הוא אחד הכלים הכי שימושיים שיש למי שמריץ agents. מקבעים את העבודה, משנים רק את המערכת שמסביב למודל, ומודדים כמה הציון זז.
מה כן נכנס פה: אותו task set, אותו ground truth, אותם מודלים. רק שני דברים משתנים:
- ה-harness: איך ה-agent מקבל את המשימה, איזה כלים יש לו, באיזה sandbox הוא רץ, כמה צעדים וכמה זמן הוא מקבל.
- ה-grader: מה נחשב “פתר”. אילו טסטים רצים, מה ה-timeout, ומה קורה עם flaky test.
ומה לא: זה לא benchmark חדש ולא מודל חדש. זה גם לא עוד תחום “engineering” שמחכה ל-job title. בפועל זה A/B על התשתית, לא על המודל. והתוצאה של DeepSWE אומרת שהתשתית לבד מזיזה משימות בעשרות נקודות.
36 נקודות בלי לגעת במודל
בגדול, לכל משימה בטבלה יש שני אחוזים ו-delta. רגע, תסתכלו על גודל ה-delta: +2.8%, -5.6%, +8.3%, -11.1%, +36.1%. כמעט הכול כפולות של 2.78, כלומר 1 מתוך 36. נראה שרוב המשימות רצו 36 פעם לכל גרסה. dynamodb-toolbox-lazy-recursive-schemas, שעלתה מ-60% ל-89%, מסתדרת יפה עם 45 הרצות.
עכשיו החשבון שאף אחד לא עושה בראש. עם 36 הרצות ואחוז פתרון סביב 50%, סטיית התקן של התוצאה היא בערך 8.3 נקודות. סטיית התקן של ההפרש בין שתי ריצות כאלה כבר מגיעה ל-11.8. אז הירידה של 8.3% ב-kysely-window-grouping-helpers וב-abs-stepped-slices קטנה מסטיית תקן אחת. רעש.
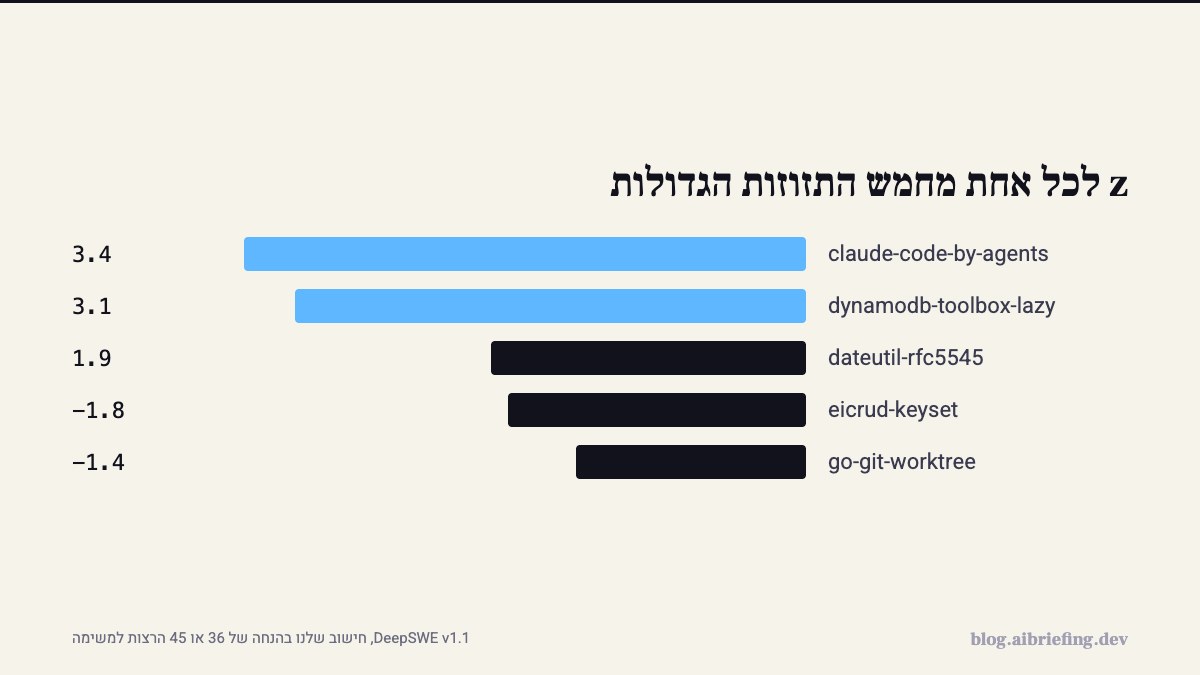
ה-36.1 של claude-code-by-agents זה סיפור אחר, עם z של בערך 3.4. זה לא מזל. משהו ב-execution או ב-grading באמת השתנה בשביל המשימה הזו. ויש גם משימות שאף harness לא הצליח להזיז: bandit-structured-nosec-directives עברה מ-3% ל-0%, ו-gql-incremental-graphql-delivery מ-6% ל-3%.
הסתייגות: אני קורא את שתי העמודות בטבלה כגרסה הקודמת מול v1.1. את מספר ההרצות אני מסיק מגודל הצעדים, לא מהתיעוד. אם Datacurve הריצו n אחר, ה-z יזוזו. העיקרון לא זז: delta בלי n הוא לא מספר.
ככה מריצים same engineering אצלכם
קודם כל, תקבעו את ה-task set בקוד: hash לכל משימה ב-repo, ולא “הרשימה מהשבוע שעבר”. חוץ מזה, תנו ל-harness ול-grader גרסאות נפרדות. ב-v1.1 של DeepSWE עודכנו גם ה-execution וגם ה-grading, ולכן מהטבלה לבד אי אפשר לדעת איזה מהשניים הזיז כל שורה. אצלכם, תשנו אחד בכל פעם.
אחר כך N הרצות לכל משימה. ריצה אחת היא הטלת מטבע. Datacurve הריצו 36, ונראה לי ש-10 זה המינימום שאפשר להסתכל עליו ברצינות. ולפני שמישהו כותב בסלאק “שיפרנו ב-15%”, בודקים את ה-delta מול הרעש:
import csv, math, sys
def load(path):    with open(path) as f:        return {r['task']: (int(r['passes']), int(r['runs'])) for r in csv.DictReader(f)}
old, new = load(sys.argv[1]), load(sys.argv[2])for task in sorted(old.keys() & new.keys()):    (a, n1), (b, n2) = old[task], new[task]    p1, p2 = a / n1, b / n2    p = (a + b) / (n1 + n2)    se = math.sqrt(p * (1 - p) * (1 / n1 + 1 / n2)) or 1e-9    z = (p2 - p1) / se    verdict = 'REAL' if abs(z) >= 2 else 'noise'    print(f'{task:45} {p1:4.0%} -> {p2:4.0%}  {p2 - p1:+6.1%}  z={z:+.1f}  {verdict}')
שומרים CSV עם העמודות task,passes,runs לכל גרסה, ומריצים python3 compare_runs.py v1_0.csv v1_1.csv. על המספרים של DeepSWE, בהנחה של 36 ו-45 הרצות, רק שתיים מחמש התזוזות הגדולות עוברות z≥2. ה-+19.4 של dateutil-rfc5545-timezone-interop וה–19.4 של eicrud נראים דרמטיים בטבלה. סטטיסטית, שניהם עדיין יכולים להיות מזל.
מתי לא לטרוח
אם ה-grader שלכם דטרמיניסטי, למשל schema שעובר או לא או unit test אמיתי, חלק גדול מהתזוזה נעלם, כי אין מה לפרש. CoLab עושים בדיוק את החלוקה הזו ב-AutoReview: AI בודק שרטוטים דו-ממדיים, ו-deterministic geometry checks מוצאים בעיות DFM בתלת-ממד. איפה שאפשר לכתוב כלל, הם כותבים כלל. ככה הם מנסחים את המטרה:
no engineering leader is trying to deploy agents for their own sake. What they want is engineering work that comes out more consistent and easier to review
— CoLab Software, על agents להנדסת תכן
“more consistent” זה בדיוק מה ש-same engineering מודד. מה שכן, יש מקרים שזה בזבוז זמן. אם יש לכם 5 משימות וריצה אחת לכל אחת, לא תראו כלום. ואם אתם בוחרים בין שני ספקים עם פער של 30 נקודות על 50 משימות, לא צריך z-test כדי להחליט.
מה לנסות השבוע
- A/A לפני A/B. תריצו את אותו config פעמיים בלי לשנות שורה. ה-delta בין שתי הריצות היא רצפת הרעש שלכם, וכל שיפור מתחתיה לא קיים.
- שני מספרי גרסה בכל תוצאה.
HARNESS_VERSIONו-GRADER_VERSIONבכל שורת תוצאות, ליד שם המודל. בלי זה אי אפשר להשוות שום דבר לאחור. - 20 משימות, 10 הרצות. 200 הרצות זה מספיק בשביל דיון רציני, ועדיין לא צריך בשבילו cluster.
- משימה שזזה ביותר מ-15 נקודות: לקרוא transcripts. לא את הציון. עשרה transcripts מכל גרסה, אחד ליד השני.
ואם ריצה שנייה של אותו config זזה אצלכם ב-10 נקודות, כל “שיפור” של 8 שדיווחתם ברבעון האחרון היה סתם רעש.
מקורות
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 4 מקורות, ונערך ואושר על ידי קובי אלמוג.