Top coding: הרשימה שהתיישנה ב-106 ימים
ב-8 ביוני Opus 4.8 קיבל 88.6%, וב-22 בספטמבר Claude Code כבר הריץ מודל אחר. מה קרה לרשימות ה-coding agents, ומה לקבע אצלכם השבוע.
- 01קבעו את המודל ב-.claude/settings.json, ושדרוג מודל עובר כ-PR.
- 02בנו eval של 20 issues סגורים מהריפו שלכם, עם טסטים.
- 03הריצו את ה-eval מחדש בכל פעם שספק מחליף מודל ברירת מחדל.
88.6%. זה הציון של Opus 4.8 ב-SWE-bench Verified, כמו שהופיע ב-8 ביוני 2026 בהשוואה של SSOJet בין 12 coding agents. לידו היו 74.6% ב-Terminal-Bench 2.1, ו-$20 לחודש כמחיר כניסה ל-Claude Code, Codex, Cursor ו-Windsurf. הפוסט הבטיח שתבחרו agent “in an afternoon”.
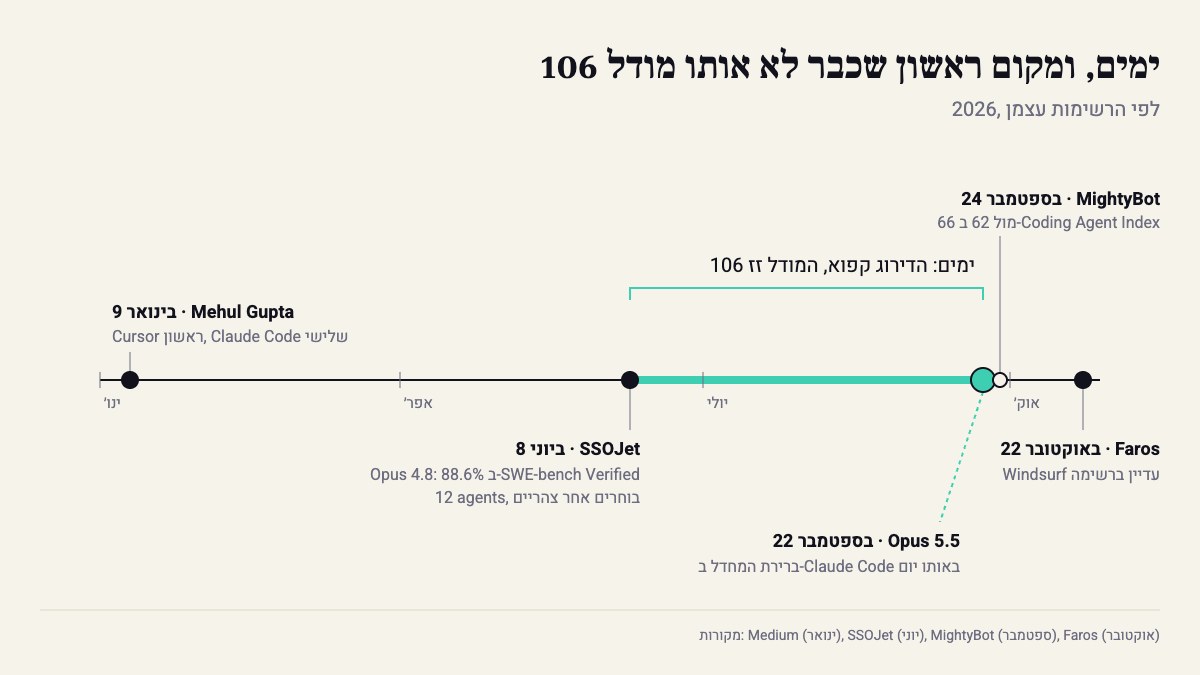
106 ימים אחר כך Claude Code כבר הריץ מודל אחר, ואחד מארבעת המוצרים ב-$20 כבר לא נקרא ככה. הפוסט הזה הוא על רשימות ה-top coding, הדירוגים של ה-coding agents המובילים, ועל מה שקורה לצוות שמחליט לפיהן ולא נוגע בהחלטה יותר.
8 ביוני: רשימה שבוחרים ממנה אחר צהריים
SSOJet השוו 12 כלים, מ-Claude Code ו-Codex ועד Antigravity, OpenCode ו-Hermes. בדיקת עובדות אחרונה: 7 ביוני. ויפה שהם כתבו בעצמם שהניסיון ה-hands-on שלהם “partial”: smoke tests על ריפו Node.js קטן, בלי deploy רב-שבועי של אף כלי. המסגרת שלהם היא ארבעה מנופים: המודל, המחיר בשימוש כבד, sub-agents במקביל, וציון ב-benchmark.
That single pair of numbers explains why benchmark scores, not marketing, now drive agent selection.
— SSOJet, “12 AI Coding Agents Compared in 2026”, יוני 2026
רגע, תסתכלו על ה-takeaways באותו פוסט. Opus 4.8 מוביל ב-SWE-bench Verified עם 88.6%, ו-GPT-5.5 “מוביל” ב-Terminal-Bench 2.0 עם 82.7%. אבל הציון של Opus שהם מביאים הוא מ-Terminal-Bench 2.1. שתי גרסאות של אותו benchmark באותה שורה, כאילו זה אותו סרגל. וזה עוד לפני שמשהו נשבר.
22 בספטמבר: ה-agent התחלף בלי שעשיתם deploy
אנטרופיק שחררו את Opus 5.5 ב-22 בספטמבר. לפי MightyBot הוא נהיה מודל ה-Opus ברירת המחדל של Claude Code באותו יום. כן, באותו יום.
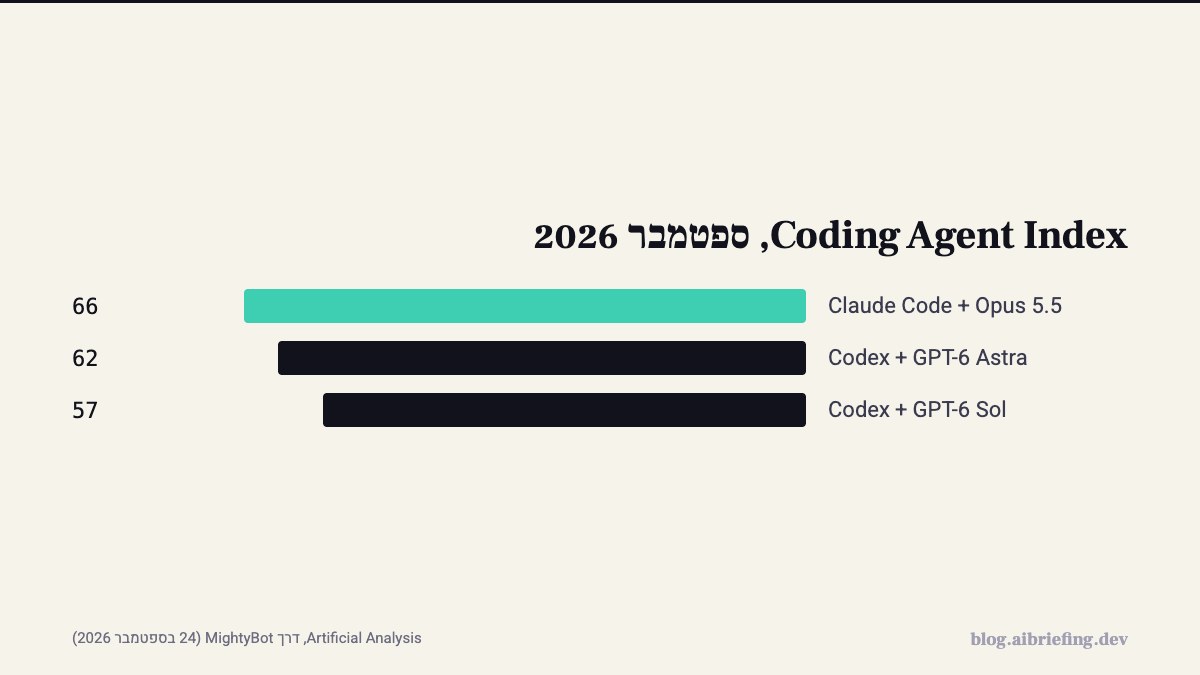
עכשיו תחשבו על צוות שבחר ב-Claude Code ביוני בגלל ה-88.6%. הקוד לא השתנה, ה-CLAUDE.md לא השתנה, ה-CI לא השתנה. אבל המודל שמחליט איזה קובץ לערוך ואיזה טסט לדלג עליו הוא מודל אחר. ובאותו יום OpenAI הוציאו את GPT-6 Sol ו-GPT-6 Luna, ו-Codex עם Sol קיבל 57 ב-Coding Agent Index של Artificial Analysis, ב-$2.99 למשימה.
ברוב המקרים זה שדרוג. אבל שדרוג שלא ביקשתם ולא מדדתם הוא שינוי בפרודקשן בלי שורה אחת ב-changelog שלכם.
מבחוץ: שתי רשימות, חודש הפרש, ומוצר שכבר לא קיים
ב-24 בספטמבר MightyBot רעננו את הדירוג. Claude Code עם Opus 5.5 ראשון, 66 מול 62 ל-Codex עם GPT-6 Astra. Cursor עלה למקום 3 אחרי ש-SpaceX השלימה את הרכישה. Devin עלה ל-4, על מודל SWE-2 של Cognition, ובלע את Windsurf, שנקרא עכשיו Devin Desktop.
ב-22 באוקטובר Faros עדכנו את הרשימה שלהם. Windsurf עדיין שם, בשורת ה-Runner Ups, ליד Aider ו-Gemini CLI.
ותחזרו עוד אחורה. ב-9 בינואר Mehul Gupta שם את Cursor ראשון ואת Claude Code שלישי, כי הוא “doesn’t integrate as smoothly with IDEs”. תשעה חודשים אחר כך Claude Code ראשון אצל MightyBot, ו-Faros עדיין קוראים ל-Cursor “the default AI IDE”.
בקיצור, מבחוץ זה נראה כמו שוק שמחליט מחדש כל חודש. בפועל אלה כמה רשימות שמודדות דברים שונים, בתאריכים שונים, על קוד של מישהו אחר.
התיקון הראשון: לרוץ אחרי המקום הראשון החדש
הרפלקס הוא לפתוח את הרשימה המעודכנת ולהחליף כלי. MightyBot עצמם עובדים ככה: refresh ביולי, refresh בספטמבר, ובכל פעם מקום ראשון אחר. זה מחליף snapshot ב-snapshot. בעוד חודשיים יצא מודל, ברירת המחדל תזוז שוב, ואתם באותה נקודה, עם עוד migration מאחוריכם.
ותסתכלו על ההפרשים. 66 מול 62 זה 4 נקודות, על אינדקס של מישהו אחר, על משימות של מישהו אחר. ואצל MightyBot עצמם Grok Build עלה למקום 5 למרות ציון חלש ב-Terminal-Bench 4.0, כי בשימוש שלהם הוא “does much more per dollar”. כלומר אפילו מי שמפרסם את הדירוג לא סומך רק על ה-benchmark.
הסיבה האמיתית: מדרגים צמד שזז
Faros ניסחו את זה הכי טוב: “Agent = Model + Harness”. המודל נותן את האינטליגנציה, וה-harness, כלומר הכלים, ההרשאות, ה-context ולולאת הטסטים, הופך אותה ל-agent. כל דירוג מצלם את הצמד הזה בתאריך אחד. ושני החצאים זזים בלי לשאול אתכם: המודל מתחלף כברירת מחדל, ה-harness מקבל sub-agents מקבילים, והמוצר עצמו נרכש או מתמזג.
וזה לא חדש. CodeRabbit מזכירים שגיטהאב השיקו את Copilot ב-29 ביוני 2021, ובמאמר ה-Codex שיצא ב-7 ביולי כתוב במפורש שמה שמריץ את Copilot זו גרסת production נפרדת של Codex. המודל שקיבל את הציון והמודל שכתב לכם קוד היו שני דברים שונים כבר ביום הראשון.
הדעה שלי: אני לא קונה החלטת כלים לפי טבלה. benchmark עונה על שאלה אחרת: איך צמד מסוים, בתאריך מסוים, פותר issues של פרויקטים פתוחים. השאלה שלכם היא מה קורה בריפו שלכם השבוע, ולזה אין טבלה.
מה לקבע אצלכם השבוע
קודם כל, תקבעו את המודל. ב-Claude Code זה "model" ב-.claude/settings.json של הריפו (או הדגל --model, או ANTHROPIC_MODEL). ב-Codex זה model ב-~/.codex/config.toml. מהרגע הזה שדרוג מודל הוא PR, לא הפתעה של יום שלישי.
{ "model": "claude-opus-5-5"}חוץ מזה, תבנו eval קטן משלכם. 15 עד 20 issues סגורים מהריפו, כל אחד עם PR ממוזג וטסטים. קובץ לכל משימה: השורה הראשונה היא ה-commit שלפני התיקון, השאר הוא ה-prompt. מריצים כל מודל ב-worktree נפרד, בלי credentials של פרודקשן ב-env, ורושמים pass/fail ועלות.
#!/usr/bin/env bash# ./agent-eval.sh claude-opus-5-5set -uo pipefailMODEL="$1"OUT="$PWD/eval/results.csv"for task in eval/tasks/*.md; do name=$(basename "$task" .md) base=$(head -n 1 "$task") wt="/tmp/eval-$name" git worktree add -q --detach "$wt" "$base" tail -n +2 "$task" | (cd "$wt" && claude -p --model "$MODEL" --permission-mode acceptEdits --output-format json) > "/tmp/eval-$name.json" if (cd "$wt" && npm test --silent >/dev/null 2>&1); then r=pass; else r=fail; fi cost=$(jq -r '.total_cost_usd' "/tmp/eval-$name.json") echo "$name,$MODEL,$r,$cost" >> "$OUT" git worktree remove --force "$wt"doneמה מודדים: אחוז המשימות שעוברות טסטים, $ למשימה, ואיזה קבצים ה-diff נגע. בשביל השוואה: $2.99 למשימה של Codex עם Sol אצל MightyBot. אם אצלכם זה פי 3, עדיף לגלות את זה לפני החשבונית.
ואז ה-assert שבאמת שווה משהו: מריצים את הסקריפט מחדש בכל פעם שספק מודיע על ברירת מחדל חדשה, ופעם בחודש בכל מקרה. MightyBot כתבו שהצוותים הטובים כבר מחלקים מודלים לפי משימה, מודל יקר לתכנון וזולים לביצוע במקביל. בלי מספרים מהריפו שלכם אין לכם על מה לבסס חלוקה כזאת.
ה-88.6% של יוני לא שיקר. הוא פשוט מדד agent שכבר לא רץ אצלכם.
מקורות
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.