Accelerating engineering: לא מונח, אלא workflow עם שערים
accelerating engineering הוא כותרת, לא מתודולוגיה. מה עובד בפועל אצל LinkedIn ו-AWS: workflow צר, שערים אנושיים ובדיקה בסוף.
דצמבר 2025, re:Invent בלאס וגאס. Shubham Mehta, PM ב-AWS Analytics, עולה לסשן ANT215 ופותח ישר במספר:
Let me start with a number. Data teams spend 60 to 70 percent of their time on undifferentiated tasks. Data engineers are spending months doing upgrades.
— Shubham Mehta, AWS Analytics, re:Invent 2025 (ANT215)
ומיד אחרי זה הוא משיק agent שמשדרג Spark מ-2.4 ל-3.5 על EMR. זה לא chatbot ולא copilot כללי. זה agent שעושה שדרוג אחד, מההתחלה ועד הסוף.
חודשיים קודם, באוקטובר 2025, Chipmind יוצאת מ-stealth עם $2.5M ופוסט בשם “Accelerating chip design with AI agents”. IBM מריצה אירוע בשם “Accelerating complex engineering tasks with AI agents”. וב-4 בנובמבר 2026 OpenAI מפרסמת את “Accelerating engineering for the physical world”. ארבע חברות, אותה כותרת.
מאיפה זה הגיע, ומה זה לא
אף אחד לא המציא את זה. זה לא מונח כמו context engineering, שמישהו ניסח בפוסט וכולם ציטטו אחריו. זו כותרת שנדבקה, כי כל חברה שמוכרת agents צריכה להסביר למנהל ההנדסה מה הוא מרוויח מזה.
בגדול, accelerating engineering זה לקחת workflow הנדסי ספציפי, כזה שחוזר על עצמו ואוכל זמן של מומחים, ולתת ל-agent להריץ אותו בשלבים, עם בדיקה בין שלב לשלב. הדוגמאות שיש בשטח: שדרוג Spark, kernels ל-GPU, verification של שבבים.
מה זה לא: זה לא “תנו לכולם Copilot ונראה מה יקרה”. זה לא autocomplete. וזו לא מתודולוגיה. אין ספר, אין paper, אין הגדרה מוסכמת. אם מישהו מציג לכם “framework של accelerating engineering”, תבקשו לראות את ה-workflow הספציפי שהוא האיץ ואת המספר של לפני ואחרי.
איך זה נראה כשזה עובד: Liger Kernel של LinkedIn
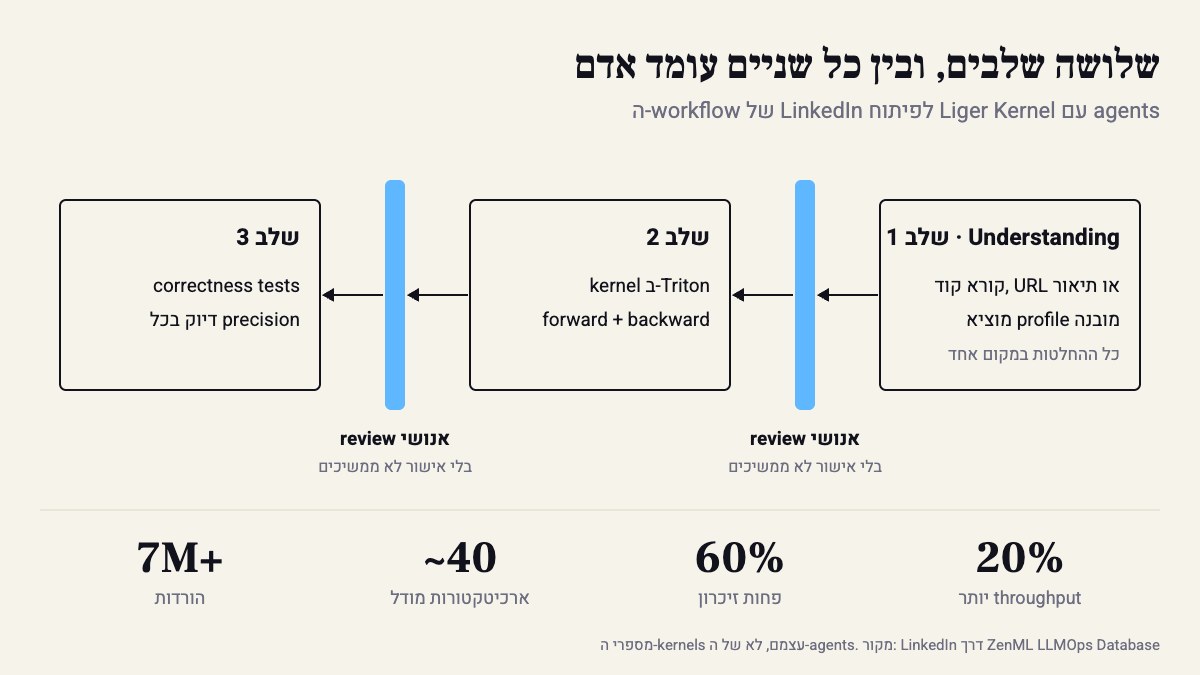
הדוגמה הכי טובה שיש כרגע דווקא לא באה מספק. Liger Kernel הוא אוסף open-source של LinkedIn ל-GPU kernels: 20% יותר throughput, 60% פחות זיכרון, כמעט 40 ארכיטקטורות מודל, יותר מ-7 מיליון הורדות ו-100+ contributors. רעיונות לא היו חסרים להם. מה שהיה חסר זה שעות של מומחה: לכתוב forward ו-backward ב-Triton, לכתוב correctness tests, לבדוק דיוק נומרי בכל precision mode.
מה שהם בנו: agent skills לשימוש חוזר, שרצים בתוך AI coding agents, ב-pipeline של שלושה שלבים עם review אנושי בין כל שלב לשלב. השלב הראשון נקרא Understanding. ה-agent קורא את הקלט (קוד, URL או תיאור חופשי) ומוציא profile מובנה עם כל ההחלטות. אדם מאשר את ה-profile. רק אז ממשיכים.
מה שגורם לזה לעבוד זה לא המודל. זה ה-artifact באמצע. profile מובנה זה משהו שבן אדם קורא בכמה דקות ואומר “לא, זה לא מתמפה לרכיב הזה”. לתקן החלטה בשלב 1 כמעט לא עולה כלום. לתקן אותה אחרי שה-kernel כבר נכתב וה-tests נפלו, זה סבב שלם.
דוגמה עם מספרים: Spark 2.4 ל-3.5
ה-agent של AWS ל-EMR עושה את אותו דבר על בעיה אחרת: planning, שינוי קוד, build, ובסוף בדיקות data quality. ארבעה שלבים, והאחרון הוא בדיקה, לא כתיבה. מי שעשה פעם שדרוג major של Spark יודע שהקוד הוא החלק הקל. החלק הקשה הוא להוכיח שהטבלאות יוצאות אותו דבר.
באותו סשן הציגו גם את SageMaker Data Agent. בדמו הוא בנה מודל customer lifetime value עם linear regression והגיע ל-R² של 81%: SQL, ויזואליזציה, one-hot encoding, ו-notebook עם 320 packages מותקנים מראש. שני ה-agents מתחברים ל-IDE דרך MCP.
רגע, ה-81% מהדמו הם לא הנקודה. הנקודה היא שה-agent עם העבודה הצרה (שדרוג) הוא זה שקל להעריך. יש קלט, יש פלט, יש diff של data quality. agent “כללי לדאטה” הרבה יותר קשה לבדוק, ולכן גם הרבה יותר קשה להגיד אם הוא האיץ משהו.
איך עושים את זה אצלכם
קודם כל, תבחרו workflow אחד. הקריטריונים: חוזר לפחות פעם בחודש, יש לו קלט ופלט ברורים, ויש דרך אוטומטית לבדוק שהתוצאה נכונה (tests, schema, diff על דאטה). שדרוג גרסה, migration של API, הוספת endpoint לפי תבנית: מועמדים טובים. “לשפר ביצועים”: לא.
חוץ מזה, תכתבו את זה כ-skill ולא כ-prompt שמודבק בצ’אט. LinkedIn ארזו את ה-workflows שלהם כ-skills שכל coding agent יכול להפעיל. בקלוד קוד זה קובץ אחד:
---name: dep-upgradedescription: Upgrade one dependency across the repo in three gated stages. Use when asked to bump a major version.---
## Stage 1 — Understand (STOP after this)- Read the changelog / migration guide for the target version.- List every call site that breaks, with file:line.- Write `upgrade-profile.md`: breaking changes, affected files, risky spots, test plan.- Do NOT edit code. Ask the human to approve the profile.
## Stage 2 — Change (only after approval)- Apply changes file by file, following the approved profile only.- Anything not in the profile: stop and ask.
## Stage 3 — Verify- Run the full test suite and the build. Paste the exact commands and their output.- Compare outputs on a fixed sample (row counts, checksums, golden files).- Report what passed and what you could not verify. No success claim without output.
בפועל, השער הכי חשוב הוא בין שלב 1 לשלב 2. ה-agent לא נוגע בקוד עד שאדם קרא את ה-profile. ואם ה-profile יוצא ארוך משני מסכים, תקצרו את התבנית. review שלוקח יותר זמן מהעבודה עצמה מבטל את כל העניין.
מתי זה לא שווה את זה
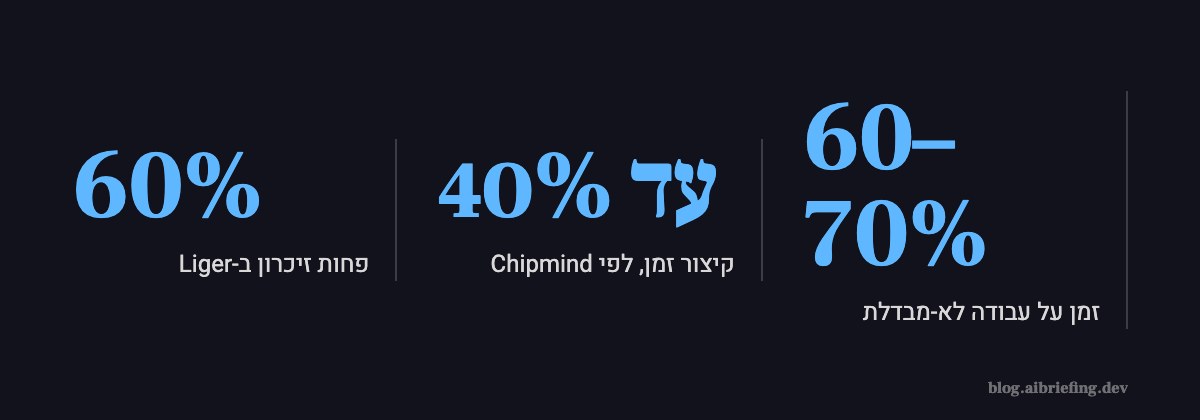
Chipmind מדברים על קיצור time-to-market של “עד 40%”. המילה “עד” סוחבת שם הרבה. AWS מדברים על 60–70% מהזמן שהולך על עבודה שלא מבדלת אתכם. זה מספר שמצדיק מוצר, לא מספר שמבטיח שה-agent יחזיר לכם אותו.
לא כדאי להתחיל כש:
- ה-workflow קורה פעמיים בשנה, ושונה בכל פעם.
- אין tests, או שאין דרך לאמת את הפלט בלי לקרוא אותו שורה-שורה.
- הידע נמצא בראש של אדם אחד שלא יכול לכתוב אותו ל-profile. קודם תוציאו את הידע, אחר כך תבנו agent.
הסתייגות: כל המספרים פה מגיעים מהחברות עצמן, על ה-workflows שלהן. ה-20% וה-60% של Liger מתארים את ה-kernels, לא את ה-agents. בתיאור הפומבי לא מצאתי מספר שאומר כמה זמן ה-agents חסכו בפועל, והייתי שמח לראות אחד.
מה לנסות השבוע
- תפתחו את היסטוריית ה-PRs של הרבעון ותחפשו את ה-workflow שחזר הכי הרבה פעמים באותו מבנה.
- תמדדו כמה זמן הוא לקח בפעם האחרונה. מספר אחד, בשעות.
- תעתיקו את ה-SKILL.md למעלה ותחליפו את שלב 3 בבדיקה שבאמת קיימת אצלכם.
- תריצו פעם אחת ותעצרו אחרי שלב 1. אם ה-profile לא שימושי, הבעיה היא לא במודל. ה-workflow פשוט לא מוגדר מספיק טוב בשביל agent.
ואם אתם לא מצליחים לכתוב את שלב 3, אין לכם עדיין מה להאיץ.
מקורות
- Accelerating Engineering for the Physical World · 2026-11-04
- Accelerating complex engineering tasks with the AI agents - IBM Developer
- AWS re:Invent 2025 - Accelerating data engineering with AI Agents for AWS Analytics (ANT215) - DEV Community
- Accelerating chip design with AI agents - Build in Digital
- LinkedIn: AI Agents Accelerating GPU Kernel Engineering for LLM Infrastructure - ZenML LLMOps Database
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.