Prompt engineering ב-2026: מה עוד שווה לכתוב ב-prompt
המודלים מבינים שפה רגילה, רוב הטריקים של 2023 מתו. מה עבר ל-context ול-harness, ומה עדיין נשאר בתוך ה-prompt.
31 במרץ 2026. מייקל היפ, שמתחזק את trello-cli, פותח טרמינל ומבקש מ-agent משפט אחד: “Add support for showing card details”. כמה דקות אחר כך יש לו פקודה. היא מציגה כותרת, תיאור ו-labels. אין due date, שזה בדיוק המידע שהוא הכי צריך. checklists אין בכלל. הוא כבר כמעט סוגר את הלפטופ.
ואז הוא קולט שה-agent עשה בדיוק מה שהוא ביקש. הוא פשוט לא אמר אילו פרטים. בניסיון השני הוא כותב חמישה משפטים: אילו flags, אילו שדות, מה עושים כשאין ערך, מה קורה כשב-checklist יש יותר מ-10 פריטים. הפעם הפקודה עובדת מיד. לפי היפ, משהו שהיה לוקח לו שעה נגמר בדקות. המודל לא השתנה. השתנה רק מה שהמודל ידע.
בגדול, זה prompt engineering בסוף 2026. לא לחשים. כתיבת דרישות.
מה מת מאז 2023, ומה נשאר
קודם כל, מה מת. ב-2023 prompt engineering היה ארגז טריקים: “think step by step”, לחזור על הכוונה שלוש פעמים, להבטיח למודל טיפ. הבלוגר yiblet כתב אז שזה מקצוע של כמה שנים. במאי 2026 הוא חזר לזה בפוסט Prompt Engineering Is Permanent, והודה שצדק רק בחצי: “That notion of Prompt Engineering is largely gone.” מודלים של 2026 מבינים שפה רגילה, ומודלי reasoning חושבים בלי שתבקשו.
מה שכן נשאר: ברגע שהמודל לא רק עונה אלא גם עושה, כלומר כותב לקבצים, קורא ל-API, שולח הודעה, ה-prompt צריך לתאר גם את הגבולות. מה לעשות, מה לא, מתי לשאול, מתי לעצור, מה נחשב הצלחה.
ומה זה לא: זה לא job title. כותב הבלוג The Infrastructure Mindset, אחרי ארבעה עשורים בתשתיות, חיפש את הדיסציפלינה ההנדסית מאחורי prompts ומצא בעיקר פוסטים שאומרים “be specific” ו-“iterate”. לגבי רוב התוכן ברשת הוא צודק. אבל זה לא אומר שאין פה מה ללמוד. זה אומר שרוב מה שצריך ללמוד יושב מחוץ ל-prompt.
מה עבר ל-context ול-harness
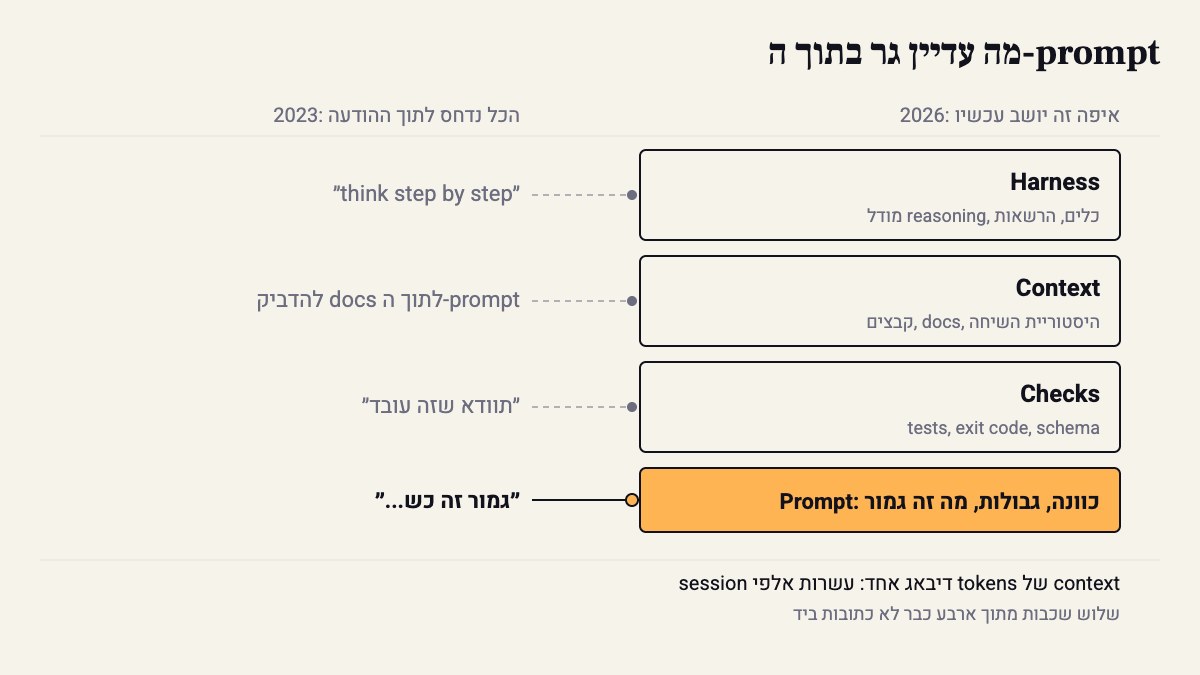
רוב מה שפעם דחסנו לתוך ההודעה עבר לשכבות אחרות. להדביק docs לתוך ה-prompt הפך ל-context engineering: מה ה-agent רואה, מאיפה ומתי. “תוודא שזה עובד” הפך ל-harness: test suite שה-agent מריץ לבד ו-exit code שהוא קורא. “think step by step” הפך לפרמטר של מודל reasoning.
המדריך של אנטרופיק ל-Claude Code אומר את זה בלי לגמגם: רוב ה-best practices נובעים מאילוץ אחד, ה-context window מתמלא מהר וה-performance יורד ככל שהוא מתמלא. session דיבאג אחד יכול לשרוף עשרות אלפי tokens. בפועל, הטקסט שאתם מקלידים הוא חלק קטן ממה שהמודל קורא.
אז מה נשאר בתוך ה-prompt? הכוונה, הגבולות, וההגדרה של “גמור”. את זה אף harness לא ימציא בשבילכם.
חמישה דברים שעדיין משנים את התוצאה
כל אחד עם לפני ואחרי. ה-prompts באנגלית כי ככה רוב הצוותים כותבים ל-agents, אבל העיקרון לא תלוי שפה.
1. תכתבו את מצב הסיום, לא את הנושא. זה הסיפור של היפ, ה-prompt שלו כמעט מילה במילה:
# beforeAdd support for showing card details
# afterAdd a card:show command that accepts --board and --list as flags.Output the card title, description, due date, any attached checklists and labels.If any of these values do not exist, skip the header for that section.If checklists have more than 10 items, add a "+ X more" entry.
2. תנו לו בדיקה שהוא יכול להריץ. אנטרופיק ניסחו את זה הכי טוב:
Claude stops when the work looks done. Without a check it can run, “looks done” is the only signal available, and you become the verification loop: every mistake waits for you to notice it. — אנטרופיק, Best practices for Claude Code
# beforeFix the date parsing bug. Make sure it works.
# afterFix the date parsing bug in src/parse.ts.Run `npm test -- parse` after every change.You're done when all tests pass, including one new testthat reproduces the bug and failed before your fix.
3. גבולות: מה אסור ומתי לעצור. yiblet כתב שאם chatbot לא מבין אתכם מקבלים תשובה גרועה, ואם agent לא מבין הוא עלול לשנות DB. ביולי 2025 זה בדיוק מה שקרה ל-Jason Lemkin עם ה-agent של Replit, שמחק DB של production באמצע code freeze.
# beforeClean up the old migration files.
# afterClean up files older than 2025-01 in db/migrations/ only.Do not touch db/seeds/ and do not run any migration.If a file is referenced from code, list it and stop. Ask before deleting.
4. שיחה חדשה במקום התיקון החמישי. בבלוג the.scapegoat.dev זה מתואר בדיוק: עוד regenerate, עוד “no, I meant this”, וה-context מתמלא ברעש שמחמיר את התשובה הבאה.
# before (5th message in the same chat)no, the other config, not that one, and keep the old flag
# after (new chat)Goal: add --dry-run to deploy.sh.Config: config/prod.yaml (not config/staging.yaml).The existing --force flag must keep working.
5. לפרק כשזה לא מחזיק. אותו בלוג: אם המודל לא מצליח במשימה, מפרקים אותה לבעיות קטנות יותר. הצעד הראשון הוא תוכנית, לא קוד.
# beforeMigrate auth to the new session library, update tests and docs.
# afterStep 1 only: read src/auth/ and write PLAN.md:which files change, in what order, what could break.Don't edit code yet. I'll review the plan first.
איך יודעים שהגרסה החדשה באמת טובה יותר ולא רק נראית ככה? זה חלק 3.
מתי זה בכלל לא בעיה של prompt
אנטרופיק כותבים את זה כבר בעמוד ה-overview: לא כל eval שנכשל נפתר ב-prompt, ולפעמים latency ועלות משתפרים מהר יותר אם פשוט מחליפים מודל. ולפני שנוגעים ב-prompt בכלל, הם מבקשים שלושה דברים: הגדרת הצלחה, דרך לבדוק אותה, וטיוטה ראשונה.
ב-the.scapegoat.dev מונים ארבע סיבות לזה שמודל נכשל: לא ניסחתם טוב, המודל באמת לא מסוגל, לא היה לכם מזל כי המודל הסתברותי, או שמשהו אחר נשבר, tool שבור או ספק שהגיש גרסה quantized. רק הסיבה הראשונה נפתרת ב-prompt. משכתבים את אותה הוראה בפעם השלישית? תעצרו ותבדקו את שלוש האחרות.
הדעה שלי: חצי מה-prompt engineering שאני רואה אצל צוותים הוא ניסיון לפתור בטקסט משהו שצריך להיות schema או test. prompts של עשרות שורות שמתחננים “תמיד תחזיר JSON תקין”, כשמה שחסר זה Structured Outputs ושורת validation. כל הוראה שעוברת לקוד היא הוראה שהמודל כבר לא יכול לשכוח.
מה לנסות השבוע
- קחו את ה-prompt האחרון שנכשל לכם וכתבו מתחתיו שורה אחת: “גמור זה כש…”. אין לכם מה לכתוב? מצאתם את הבאג.
- תנו למודל את הבקשה המקורית של היפ ותבקשו ממנו לשאול חמש שאלות לפני שהוא כותב קוד. התשובות לשאלות האלה הן ה-prompt שהיה חסר.
- ב-Claude Code: תגדירו status line שמראה כמה context נשרף, כמו שאנטרופיק ממליצים, ותעשו
/clearבין משימות. - ב-OpenAI: אם אתם מבקשים JSON בטקסט, תעברו ל-Structured Outputs. ותפסיקו לקרוא
output[0].content[0].text. OpenAI כותבים במפורש שזה לא בטוח, כי ה-output יכול להכיל tool calls ו-reasoning. ישoutput_text.
ואם ה-prompt שלכם לא מחזיק בשיחה חדשה, בלי כל ההיסטוריה שמאחוריו, הוא לא prompt. הוא שיחה.
מקורות
- Prompt engineering overview
- Prompt engineering | OpenAI API
- Best practices for Claude Code - Claude Code Docs
- Prompt Engineering for Humans · 2026-03-31
- From prompt and pray to prompt engineering · 2026-05-07
- Prompt Engineering Is Not. Engineering, That Is · 2026-04-01
- Prompt Engineering Is Permanent · 2026-05-03
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 7 מקורות, ונערך ואושר על ידי קובי אלמוג.