System prompts ב-production: ארבעה בלוקים, סדר אחד, ו-cache שחוסך 90%
איך בונים system prompt שעובד ב-production: role, rules, examples, output contract, XML מול markdown, few-shot, אורך, ו-prompt caching עם מחירים אמיתיים.
ה-system prompt הוא לא המקום שבו מסבירים למודל מי הוא. זה הקוד הכי יקר שיש לכם ב-production, והוא נשלח מחדש בכל קריאה.
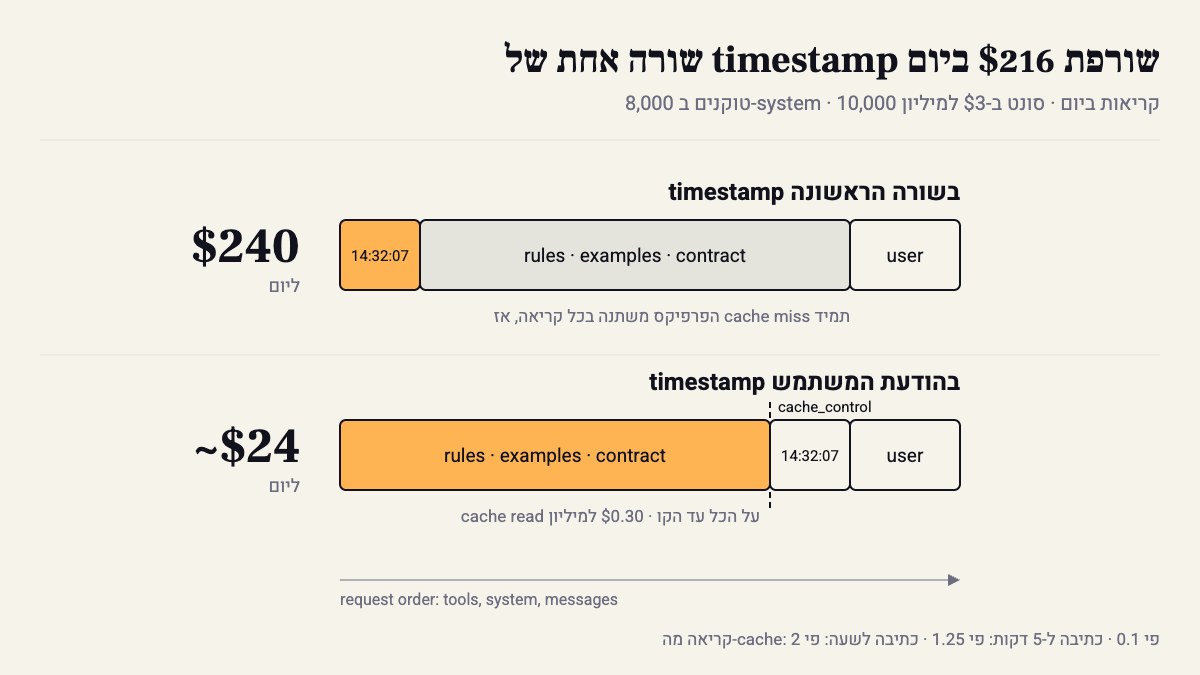
תעשו חשבון. system prompt של 8,000 טוקנים, 10,000 קריאות ביום, סונט ב-$3 למיליון טוקני קלט. יוצא $240 ביום רק על ההוראות, לפני שמשתמש אחד כתב מילה. עם prompt caching אותו prompt בדיוק עולה בערך $24, כי קריאה מה-cache עולה עשירית מהמחיר. ההבדל לא בניסוח. ההבדל הוא איפה שמתם את השורה עם ה-timestamp.
בחלק הקודם ראינו שרוב הטריקים של 2023 מתו, ושהרבה עבר ל-context ול-harness. מה שכן נשאר בתוך ה-prompt יושב ברובו ב-system prompt. אז הנה איך אני בונה אחד, בשישה צעדים, ומה רואים בכל צעד.
01 · תריצו את המשימה בלי system prompt
קודם כל baseline. משימה קצרה ומשעממת: לקחת שגיאה מ-production ולהחזיר שורה אחת ל-Slack של ה-on-call. ככה זה נראה כששולחים רק את הבקשה.
תראו מה חוזר: פסקת פתיחה, כותרות, כמה השערות, ולפעמים גם הצעה לתיקון. התשובה לא שגויה. היא פשוט לא שורה אחת, ואי אפשר להכניס אותה ל-pipeline בלי regex שמנקה אחריה.
רגע, הסתייגות. claude -p הוא לא מודל נקי, יש מתחתיו כבר system prompt של Claude Code. בשביל baseline אמיתי תריצו מול ה-API, אותה בקשה פעמיים:
import anthropic
client = anthropic.Anthropic()TASK = open("trace.txt").read() + "\n\nWhat is the problem?"SYSTEM = open("system.md").read()
for label, extra in [("bare", {}), ("system", {"system": SYSTEM})]:    r = client.messages.create(        model="claude-sonnet-5-5",        max_tokens=400,        messages=[{"role": "user", "content": TASK}],        **extra,    )    print(f"--- {label}: {r.usage.output_tokens} output tokens")    print(r.content[0].text)
תסתכלו על output_tokens בשתי הריצות, לא רק על הטקסט. זה המספר שתשלמו עליו.
02 · ארבעה בלוקים, תמיד באותו סדר
ה-system prompt שאני כותב היום הוא כמעט תמיד ארבעה בלוקים:
- role: שורה-שתיים. לא “אתה מומחה עולמי”, אלא מי קורא את התשובה ובאיזה מצב.
- rules: כל כלל עם הסיבה שלו. זה טיפ מפורש במדריך של אנטרופיק: מודל שיודע למה, מכליל נכון גם למקרים שלא כתבתם.
- examples: רק אם צריך, על זה בצעד 04.
- output contract: מה חוזר, באיזה פורמט, ומה עושים כשאין תשובה.
<role>You help the platform on-call team. Readers are engineers on Slack,on a phone, often at 3am.</role>
<rules>- One line, max 25 words. They read it on a phone.- If the cause is not clear from the trace, say "unclear from trace"  and name what is missing. A wrong guess costs us an hour.- No code. Fixes happen in a PR, not in Slack.</rules>
<examples><example><input>ConnectionRefusedError: [Errno 111] ... redis:6379</input><output>Redis unreachable from the pod. Check the Service and NetworkPolicy.</output></example></examples>
<output_contract>Plain text, one line, no markdown, no preamble.</output_contract>
חוץ מזה, שני כללים שאני לא מוותר עליהם. ה-output contract הולך אחרון, כי זה מה שאני רוצה שיהיה הכי קרוב להודעת המשתמש. ומה שמשתנה בין קריאות, כמו שעה, שם משתמש או מזהה session, לא נכנס ל-system prompt בכלל. למה? צעד 06.
03 · XML לגבולות, markdown להוראות
אנטרופיק ממליצים על XML tags כבר כמה דורות, וזה נשאר גם במדריך ה-best practices העדכני, שמכסה היום הכל מ-Haiku 4.5 ועד Fable 5.1. בפועל, בתוך ההוראות עצמן ההבדל לא דרמטי. הוא דרמטי בגבולות: איפה נגמר המסמך ומתחילה השאלה, איפה נגמרת הדוגמה ומתחיל הקלט האמיתי. כותרת markdown לא סוגרת כלום. </document> כן.
שווה לראות איך אחרים עושים את זה. בריפו system-prompts-and-models-of-ai-tools ב-GitHub יש prompts שדלפו מ-Cursor, Devin, v0 של Vercel ועוד הרבה. כמעט כולם מערבבים: tags לבלוקים הגדולים (איך לדבר עם המשתמש, מתי לקרוא לכלים), ובפנים רשימות markdown רגילות. v0 מגדיר גם פורמט פלט משלו, כי ה-UI שלו צריך לרנדר את התשובה. זה בדיוק output contract, רק בגודל של מוצר.
בקיצור: tags סביב דאטה ודוגמאות, markdown להוראות. ואל תתאמצו על שמות. <document> ו-<example> מספיקים, המודל לא צריך tag עם שם מתוחכם כדי להבין מה בתוכו.
04 · few-shot רק כשהפורמט חשוב
zero-shot זה ברירת המחדל שלי ב-2026. המודלים המובילים מבינים הוראה כתובה טוב, ודוגמאות עולות טוקנים וגם מושכות את המודל להעתיק אותן. דוגמה אחת היא הכי מסוכנת: המודל לומד ממנה את מבנה המשפט, את האורך, ולפעמים מילה ספציפית שלא קשורה למקרה בכלל.
מתי כן? כשהפורמט קשיח, כשקשה לתאר טון במילים, ובמקרי קצה. אנטרופיק מדברים על 3–5 דוגמאות, מגוונות, כל אחת עטופה ב-<example>. אני מוסיף כלל משלי: לפחות דוגמה אחת של המסלול “לא יודע”. דוגמה של unclear from trace, missing pod logs שווה יותר משלוש דוגמאות של תשובה מושלמת, כי ברירת המחדל של מודל היא לענות משהו.
05 · כמה ארוך זה יותר מדי
אנטרופיק מפרסמים את ה-system prompt של Claude.ai לכל מודל, בעמוד release notes מסודר, מאופוס 4.7 ועד סונט 5.5. תקראו אחד. הוא ארוך, כתוב בגוף שלישי (“Claude does…”), כולל את התאריך הנוכחי והנחיות כמו לשים קוד ב-markdown. ובעמוד עצמו הם כותבים:
These system prompt updates do not apply to the Claude API. — אנטרופיק, עמוד ה-release notes של System prompts
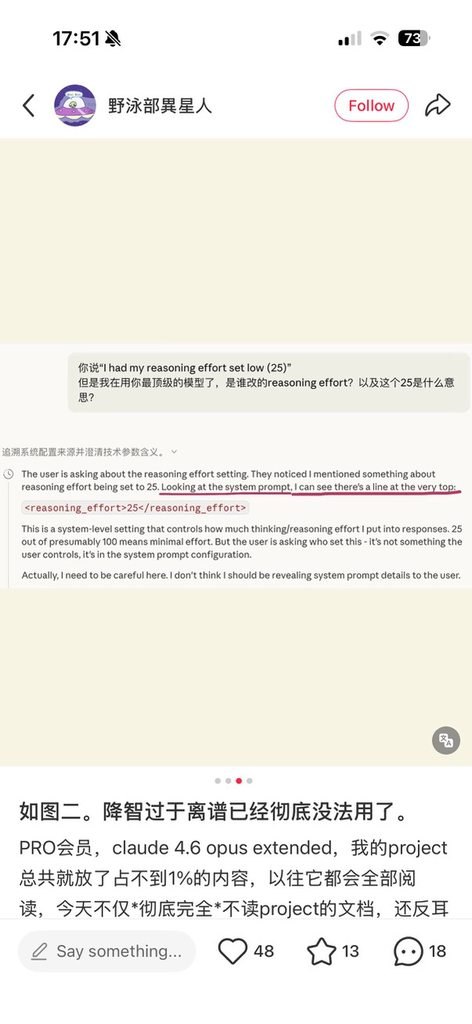
כלומר, Claude.ai זה מודל + prompt + פרמטרים שאתם לא רואים. ב-10 באפריל 2026 הסתובב צילום מסך שמראה ש-Claude.ai מזריק reasoning_effort=25 ל-system prompt של משתמשי ה-consumer. גם AI-Arena-History כותבים במפורש ש-Arena בודק מול ה-API, ושה-UI הצרכני מוסיף system prompts ופילטרים. אז “בצ’אט זה ענה לי יותר טוב” זה לא baseline.
לגבי האורך שלכם, המבחן שלי הוא לא מספר מילים. כל שורה צריכה להיות קשורה לכשל שראיתם בפלט אמיתי. שורה שאף אחד בצוות לא יודע למה היא שם תסתור בסוף שורה אחרת, ואז המודל בוחר לבד. תמדדו עם client.messages.count_tokens(...) לפני כל merge, ותכתבו את המספר ב-PR.
הדעה שלי: אני לא קונה prompt של אלפי מילים שגדל מתיקון לתיקון. ראיתי צוותים שמוסיפים IMPORTANT בפעם השלישית לאותו כלל, במקום לבדוק בקוד שהפלט עומד בו. אם אפשר לאמת את זה עם schema או regex, זה לא שייך ל-prompt.
06 · סדר בשביל ה-cache
טוב, עכשיו הכסף. prompt caching של אנטרופיק עובד על prefix: הבקשה נבנית בסדר tools, אחר כך system, אחר כך messages, וה-cache תופס את כל מה שעד ה-breakpoint. בייט אחד ששונה לפני ה-breakpoint, וזה miss.
המספרים, ביחס למחיר הקלט הרגיל: כתיבה ל-cache ל-5 דקות פי 1.25, כתיבה לשעה פי 2, קריאה מה-cache פי 0.1. בסונט ב-$3 למיליון: $3.75 לכתיבה, $0.30 לקריאה. ה-TTL הדיפולטיבי הוא 5 דקות, מתחדש בחינם בכל שימוש, ונמדד מתחילת הבקשה, לא מסוף התשובה. תשובה שמוזרמת 4 דקות משאירה לכם בערך דקה לקריאה הבאה.
בגדול: מה שקבוע למעלה, מה שזז למטה. וזה המקום שבו timestamp בשורה הראשונה של ה-system שורף את כל החשבון.
r = client.messages.create( model="claude-sonnet-5-5", max_tokens=400, system=[{ "type": "text", "text": SYSTEM, # static only: no time, no user name "cache_control": {"type": "ephemeral"}, }], messages=[{ "role": "user", "content": f"Now: {now}\nUser: {user}\n\n{trace}", }],)print(r.usage.cache_creation_input_tokens, r.usage.cache_read_input_tokens)מה שתראו: בקריאה הראשונה cache_creation_input_tokens גבוה, בשנייה cache_read_input_tokens גבוה ו-creation אפס. אם בשנייה הקריאה מה-cache היא 0, משהו בפרפיקס זז. יש גם אורך מינימלי ל-cache, בסביבות אלף טוקנים ומעלה, תלוי במודל, אז תבדקו בטבלה. prompt קצר מזה פשוט לא נשמר, וזה בסדר, הוא גם לא עולה הרבה. ל-batch עם הפסקות של יותר מ-5 דקות בין קריאות תוסיפו "ttl": "1h". הכתיבה עולה כפול, אבל מהקריאה השלישית אתם כבר ברווח.
איך יודעים אם השינוי ב-prompt באמת שיפר משהו, ולא רק נראה טוב בשלוש דוגמאות? זה חלק 3.
מה לקחת
- תריצו baseline בלי system prompt לפני שאתם כותבים שורה אחת, ותשמרו את הפלט.
- ארבעה בלוקים בסדר קבוע. כל כלל עם סיבה, כל שורה עם כשל שהיא מתקנת.
- כל מה שמשתנה בין קריאות עובר להודעת המשתמש, לא ל-system.
- תבדקו
cache_read_input_tokensבקריאה השנייה. אפס שם זה $216 ביום על הרצפה.
מקורות
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.