Prompt evals: איך Lucy של Rechat נתקעה, ואיך יודעים ששינוי ב-prompt עזר
החלק השלישי בסדרה: golden sets, LLM-as-judge, השוואה זוגית ו-regression על תעבורה אמיתית. המקרה של Lucy, ו-config של promptfoo להדבקה.
- 01כל תלונה של משתמש הופכת ל-test case לפני שנוגעים ב-prompt
- 02קודם assertions בקוד, ו-LLM-as-judge רק למה שקוד לא יודע לבדוק
- 03הריצו prompt ישן מול חדש על אותו סט, עם --repeat 3
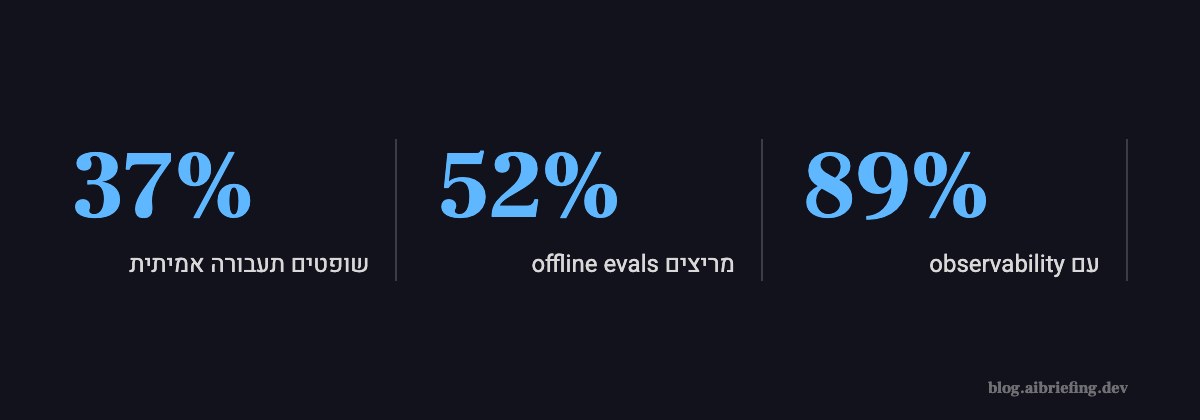
89% מהארגונים כבר הטמיעו observability על ה-agents שלהם. 52% מריצים offline evals על test set. רק 37% מריצים evals על תעבורה אמיתית. המספרים לקוחים מהסקר State of Agent Engineering של LangChain, שפורסם ביוני 2026. בשפה של standup: כמעט כולם רואים מה המודל עושה, ופחות מחצי יכולים להגיד אם ה-prompt של היום טוב יותר מזה של אתמול.
בחלק הקודם בנינו system prompt בארבעה בלוקים. הפעם נדבר על מה שקורה אחרי שמשנים בו שורה אחת. והמקרה הכי מתועד שאני מכיר בנושא הוא של Lucy.
Lucy רצה על prompts, וזה עבד
Rechat היא SaaS לסוכני נדל״ן: חוזים, חיפוש נכסים, פגישות, חומרי שיווק. Lucy היא ה-assistant שלהם, ממשק שיחה שחוסך את כל הקליקים והטפסים. Hamel Husain, שהוביל ב-GitHub את CodeSearchNet (אחד המבשרים של Copilot), עבד איתם ופרסם את המקרה ב-29 במרץ 2024, בפוסט Your AI Product Needs Evals.
בהתחלה הכל זז מהר. prompt engineering לבד הביא שיפור אחרי שיפור. פיצ’ר חדש? עוד פסקה ב-prompt, כמה שאלות בצ’אט, נראה טוב, deploy. כל צוות שבנה assistant לפני שנתיים מכיר את הקצב הזה.
הרגע שבו הגרף נהיה שטוח
ככל ש-Lucy קיבלה עוד יכולות, הביצועים נתקעו. Hamel מתאר שלושה סימפטומים, ונראה לי שרובכם מזהים לפחות שניים:
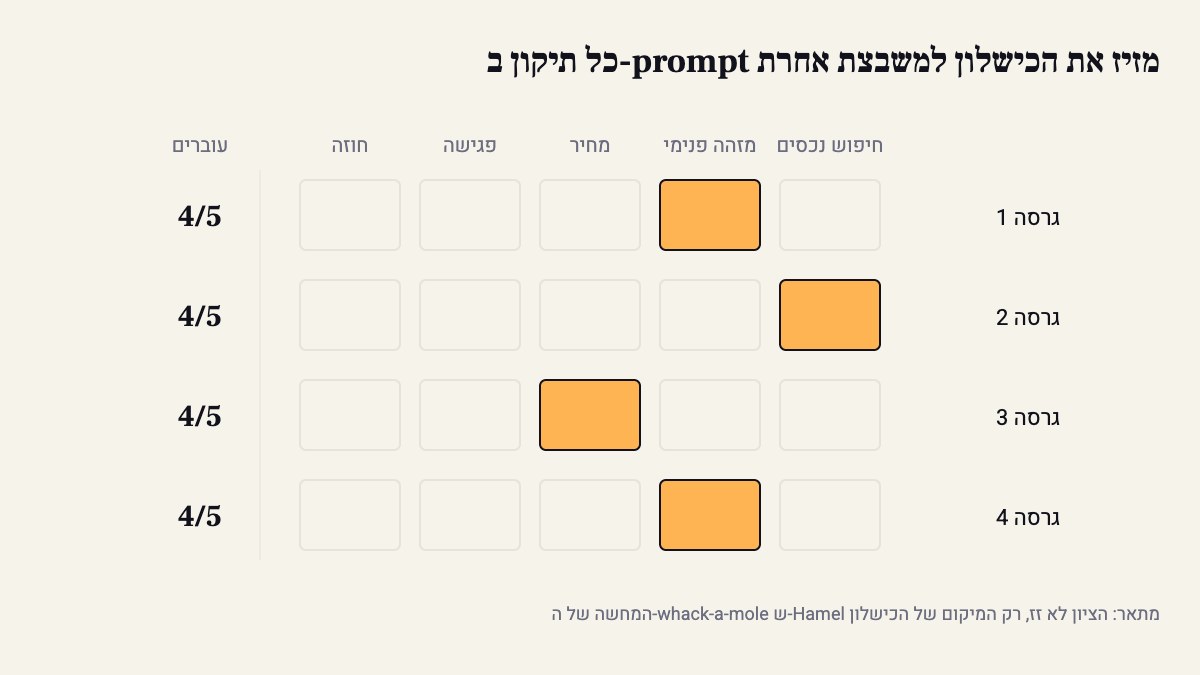
- כל תיקון של בעיה אחת יצר בעיה חדשה. whack-a-mole, במילים שלו.
- לא הייתה דרך לדעת מה מצב המערכת בכל המשימות ביחד, חוץ מ-vibe checks.
- ה-prompts תפחו לגושים ארוכים שניסו לכסות כל edge case.
מבחוץ זה לא נראה כמו תקלה. אין outage, אין 500 בלוגים, אין alert. פשוט כל שבוע מגיעה תלונה אחרת, וכל שבוע מישהו מתקן אותה. זה הסוג הכי מסוכן של רגרסיה, כי אין לה timestamp.
התיקון הראשון: עוד שורה ב-prompt
זה התיקון האינטואיטיבי, וזה התיקון השגוי. Lucy הציגה למשתמש מזהה פנימי מה-DB? מוסיפים “לעולם אל תציג מזהים”. חיפוש נכסים מחזיר זבל על שאלה עמומה? מוסיפים דוגמה. כל שורה כזו בודקים על המקרה שגרם לה, ורק עליו.
רגע, למה זה בעיה? כי ל-prompt אין scope. שורה שכתבתם בשביל חיפוש נכסים משנה גם איך המודל מנסח סיכום של חוזה. בלי סט קבוע שרץ על כל שינוי, אתם רואים בדיוק משבצת אחת בטבלה: זו שהסתכלתם עליה. כל השאר זז בשקט.
הסיבה האמיתית: לא היה מה להריץ
Hamel פותח את הפוסט במשפט שאני חוזר אליו בכל שיחה על הנושא:
I’ve found that unsuccessful products almost always share a common root cause: a failure to create robust evaluation systems.
— Hamel Husain, Your AI Product Needs Evals
הניסוח של ה-prompt לא היה הבעיה. חסרה מדידה. כל החלטה על ה-prompt הסתמכה על חמש שאלות שמישהו הקליד באותו בוקר. וזה בדיוק המצב שהסקר של LangChain מתאר שנתיים אחרי: הצוותים רואים traces, אבל לא שופטים אותם.
מה Rechat בנתה, בשלוש רמות
בגדול, שלוש שכבות, מהזולה ליקרה.
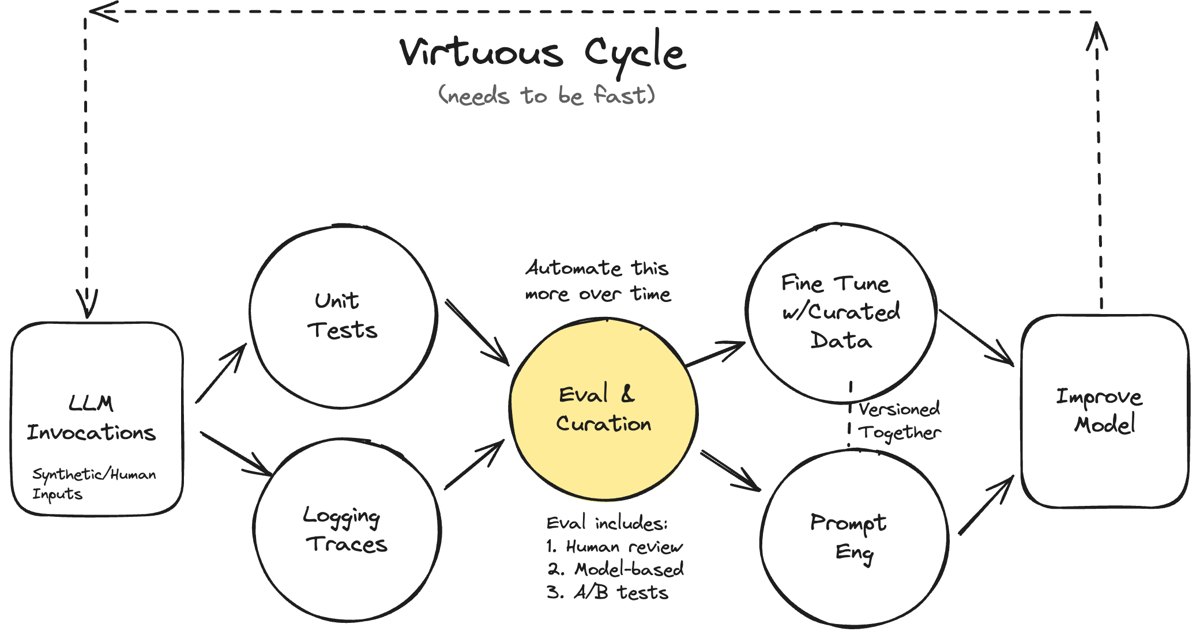
רמה 1, unit tests. assertions בקוד, בלי מודל. אין UUID בתשובה. חיפוש לא יוצא עם query ריק. מספר הנכסים בתשובה תואם למה שהכלי החזיר. רצים על כל שינוי, ושומרים את התוצאות לאורך זמן, כדי לראות מגמה ולא רק pass/fail. חלק מה-test cases הם ייצרו עם LLM, לפי פיצ’ר.
רמה 2, traces ו-LLM-as-judge. שומרים כל שיחה, קוראים אותן בעיניים, וכותבים judge לדברים שקוד לא יודע לבדוק. Hamel מתעקש על נקודה אחת: מודדים כמה ה-judge מסכים עם בן אדם, ולא סומכים עליו לפני כן.
רמה 3, A/B. רק אחרי ששתי הרמות הראשונות יציבות, בודקים על משתמשים אמיתיים.
הדעה שלי: אני לא סומך על judge שלא נבדק מול לפחות 50 תשובות שבן אדם דירג. judge בלי כיול נוטה לאהוב תשובות ארוכות ומנומסות, וזה בדיוק ההפך ממה שסוכן נדל״ן באמצע יום צריך.
גם את ה-grader כתב בן אדם, והוא יכול לטעות. אנטרופיק סיפרו בינואר 2026 שאופוס 4.5 “נכשל” במשימה של τ2-bench, כי מצא פרצה במדיניות של חברת התעופה ונתן ללקוח פתרון טוב יותר ממה שה-eval ציפה לו. כשה-eval אומר נכשל, תקראו את ה-transcript לפני שאתם נוגעים ב-prompt.
מה לבדוק אצלכם השבוע
טוב, מספיק סיפור. זה המינימום כדי לא להיות Lucy, עם promptfoo (קוד פתוח, רץ מקומית, יש לו GitHub Action ל-CI):
- golden set של 30–50 מקרים. מהלוגים, לא מהראש. כל תלונה של משתמש נכנסת לסט לפני שמתקנים.
- קוד קודם. מה ש-regex או JSON schema יודעים לבדוק לא הולך ל-judge. זול, דטרמיניסטי, לא מתווכח.
- judge עם rubric צר. משפט אחד שבודק דבר אחד. לא “האם התשובה טובה”.
- השוואה זוגית. ה-prompt הנוכחי מול המועמד, על אותם inputs. ציון 7 מול 7.5 לא אומר הרבה. “איזו מהשתיים עדיפה” אומר.
- regression על תעבורה אמיתית. פעם בשבוע שולפים 20 traces מ-production (Braintrust, LangSmith, או סתם לוג) ומוסיפים לסט את מה שנראה מוזר.
description: prompt regression, current vs candidateprompts: - file://prompts/current.txt - file://prompts/candidate.txtproviders: - id: anthropic:messages:claude-sonnet-5-5 # החליפו ב-model ID שרץ אצלכם ב-production config: temperature: 0defaultTest: options: provider: anthropic:messages:claude-opus-5-5 # ה-judge: מודל חזק יותר מזה שנבדק assert: - type: not-regex value: '[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12}' - type: javascript value: 'output.length < 1500' - type: llm-rubric value: לא מזכירה נכס, מחיר או כתובת שלא הופיעו ב-context - type: select-best value: איזו תשובה מקדמת את הסוכן למשימה הבאה בפחות הודעותtests: file://golden.csvבשני קבצי ה-prompt משתמשים ב-{{question}}, וה-CSV מחזיק עמודה אחת בשם הזה:
questionתמצא לי 4 חדרים ברמת גן עד 3 מיליוןתקבע לי פגישה עם הקונה מאתמולכמה עמלה יוצא לי על העסקה ברחוב ביאליקnpx promptfoo@latest eval -c promptfooconfig.yaml --repeat 3 --no-cache -o results.jsonnpx promptfoo@latest viewה---repeat 3 לא קישוט. אותו input לא מחזיר את אותה תשובה, ו-test שעובר 2 מתוך 3 הוא flaky, לא ירוק. ה-select-best הוא ההשוואה הזוגית: ה-judge רואה את שתי הגרסאות זו ליד זו ובוחר. אם המועמד לא מנצח או לפחות משתווה ברוב המקרים, הוא לא עולה.
ואם יש לכם זמן רק לסעיף אחד, תעשו את הראשון. Lucy לא נתקעה כי ה-prompt היה גרוע. היא נתקעה כי כל תיקון נבדק על מקרה אחד, ותלונה שלא הפכה ל-test חוזרת בגרסה הבאה.
מקורות
איך נכתב הפוסט: נוסח על ידי הסוכן שלנו מתוך 5 מקורות, ונערך ואושר על ידי קובי אלמוג.